Cuántos sitios bloquean bots de IA en robots.txt (5 071)
El 15 y 16 de noviembre de 2026 leímos el robots.txt de 4 772 sitios web: el 15,1% de ellos (719) le dice a al menos un rastreador de IA que no entre en todo el sitio mediante una regla Disallow: /. El bot más bloqueado es Bytespider de ByteDance (12,0%), seguido de CCBot de Common Crawl (11,9%)…
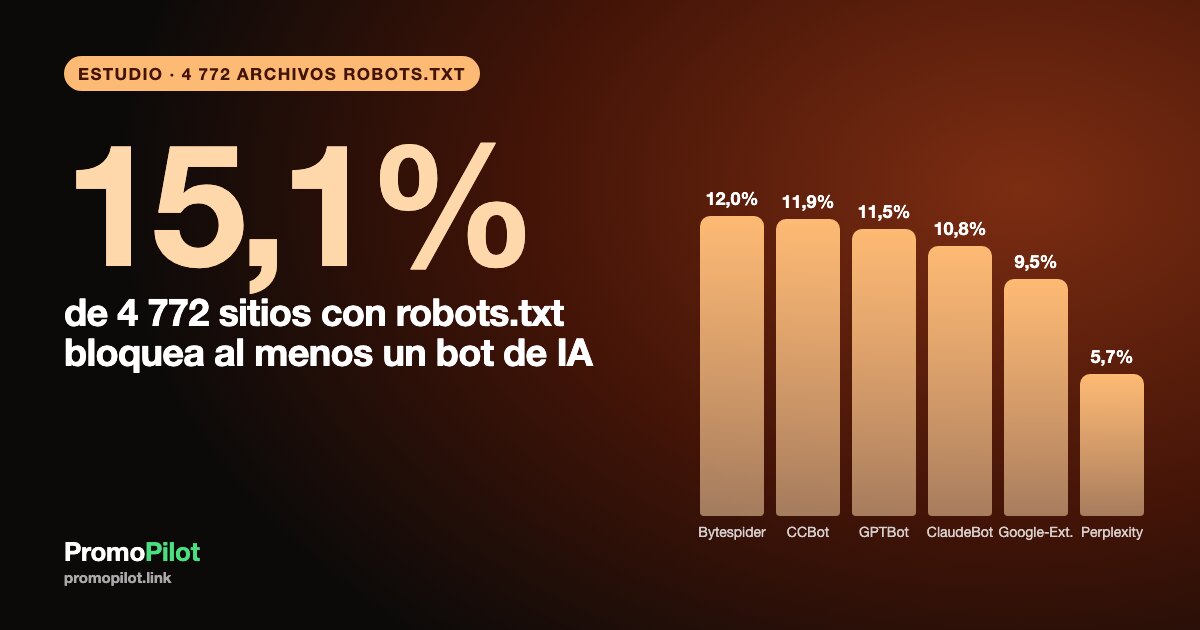
El 15 y 16 de noviembre de 2026 leímos el robots.txt de 4 772 sitios web: el 15,1% de ellos (719) le dice a al menos un rastreador de IA que no entre en todo el sitio mediante una regla Disallow: /. El bot más bloqueado es Bytespider de ByteDance (12,0%), seguido de CCBot de Common Crawl (11,9%) y GPTBot de OpenAI (11,5%); los bots que obtienen páginas para respuestas en vivo y búsqueda con IA se bloquean mucho menos (OAI-SearchBot 3,6%). Aparte: el 22,5% de 5 071 sitios sirve un archivo llms.txt real, y los sitios que bloquean bots de IA lo tienen con menos frecuencia (15,6% frente a 25,1%). A continuación: el ranking de bots, qué es cada bot y qué hace y qué no hace bloquearlo, el panorama de llms.txt, una tabla de decisión para su propio sitio y la metodología. Advertencia: la muestra no es aleatoria (sitios de nuestra caché de resultados de búsqueda), así que las cifras describen esta muestra, no toda la web.
Datos: rastreo de PromoPilot de 6 000 sitios, 15 y 16 de noviembre de 2026 (comprobación de llms.txt el 16 de noviembre); se excluyeron 661 sitios tras un WAF, 178 inaccesibles y 90 con otros errores, 5 071 en el cálculo, robots.txt encontrado en 4 772
Cifras clave
- El 15,1% de los sitios (719 de 4 772 con robots.txt) bloquea al menos uno de los 10 bots de IA que seguimos. De ellos, 121 (2,5% de todos los sitios) tienen además un
Disallow: /general para todos los rastreadores, de modo que la parte dirigida específicamente a bots de IA son 598 sitios, 12,5%. - Ranking por bot: Bytespider 12,0%, CCBot 11,9%, GPTBot 11,5%, ClaudeBot 10,8%, Google-Extended 9,5%, anthropic-ai 8,8%, Applebot-Extended 8,2%, PerplexityBot 5,7%, ChatGPT-User 5,3%, OAI-SearchBot 3,6%.
- El bloqueo suele ser de todo o nada: de los 719 sitios que bloquean, 379 (52,7%) bloquean 7 o más de los 10 bots, 95 (13,2%) bloquean los 10 y 100 (13,9%) bloquean exactamente uno.
- Entrenamiento frente a consulta en vivo: el 15,0% de los sitios bloquea al menos un bot de entrenamiento, el 6,6% bloquea al menos un bot de búsqueda o consulta y el 8,4% bloquea solo bots de entrenamiento. De los 549 sitios que bloquean GPTBot, 382 (69,6%) dejan abierto OAI-SearchBot.
- Content-Signal (la directiva de robots.txt para preferencias de search, ai-input y ai-train) aparece en el 5,4% de los sitios (258); 90 de ellos la usan sin bloquear ningún bot.
- llms.txt: archivo real en el 22,5% de 5 071 sitios (1 139), llms-full.txt en el 5,1% (259); el 8,6% (435) responde 200 con una página HTML de relleno o una redirección, que no contamos; el 63,5% devuelve 404.
- Los sitios que bloquean bots de IA sirven llms.txt con menos frecuencia: 15,6% (112 de 719) frente a 25,1% (1 019 de 4 053 que no bloquean), entre los sitios con robots.txt.
- Por CMS (etiqueta generator): el 17,6% de los sitios sin etiqueta generator bloquea al menos un bot de IA, WordPress 9,3% (462 sitios), Drupal 19,1% (47), otros CMS y constructores 5,3% (587).
Ranking: cuántos sitios bloquean cada bot de IA
Para cada sitio analizamos el robots.txt y registramos cuáles de 10 user agents de IA tienen prohibido el acceso a todo el sitio. La base son los 4 772 sitios donde se encontró un robots.txt (94,1% de los 5 071 que pudimos leer). El ranking está a continuación.

| # | Bot | Sitios que lo bloquean | Porcentaje de 4 772 |
|---|---|---|---|
| 1 | Bytespider | 571 | 12,0% |
| 2 | CCBot | 569 | 11,9% |
| 3 | GPTBot | 549 | 11,5% |
| 4 | ClaudeBot | 515 | 10,8% |
| 5 | Google-Extended | 452 | 9,5% |
| 6 | anthropic-ai | 421 | 8,8% |
| 7 | Applebot-Extended | 391 | 8,2% |
| 8 | PerplexityBot | 271 | 5,7% |
| 9 | ChatGPT-User | 254 | 5,3% |
| 10 | OAI-SearchBot | 173 | 3,6% |
Destacan dos patrones. Primero: las siete primeras posiciones son bots que recogen datos para entrenar modelos, o tokens vinculados al entrenamiento; las tres últimas están ligadas a la búsqueda y las respuestas. Los propietarios bloquean con mucha más facilidad “el bot que se entrena con mi contenido” que “el bot que quizá me envíe una visita”. Segundo: el token heredado anthropic-ai (8,8%) se sigue bloqueando casi tanto como ClaudeBot (10,8%): 384 sitios bloquean ambos y 552 (11,6% del total) bloquean al menos uno de los dos, lo que sugiere que muchos robots.txt se copian de listas ya hechas en lugar de escribirse bot por bot.
Para la mayoría de los sitios, el bloqueo es de todo o nada
Los 719 sitios que bloquean no eligen bot por bot. La mitad (379) bloquea siete o más bots, 95 bloquean los diez y solo 100 bloquean uno.

Una precisión sobre la propia cifra. Nuestro analizador da un bot por bloqueado cuando su regla prohíbe todo el sitio. 121 de los 719 sitios llevan además un Disallow: / general para todos los rastreadores, que cierra el sitio también a los buscadores (2,5% de todos los sitios con robots.txt; algunos son sitios en construcción). Si quiere la parte específica de bots de IA, réstelos: 598 sitios, 12,5%.
Anatomía: qué es cada bot y qué hace y qué no hace bloquearlo
“Bloquear la IA” no es una sola decisión. Los diez user agents pertenecen a tres trabajos distintos: recoger páginas para entrenar modelos, construir un índice de búsqueda que responde preguntas con citas y obtener una página ahora mismo porque una persona se lo pidió a un asistente. Bloquear cada uno tiene un efecto distinto. Las descripciones siguen la documentación pública de los proveedores tal como la leímos en noviembre de 2026; la documentación de los rastreadores cambia, así que revise las páginas enlazadas antes de apoyarse en un detalle.
| Bot | Operado por | Función | Qué hace bloquearlo | Qué no hace |
|---|---|---|---|---|
| GPTBot | OpenAI | Rastreador de entrenamiento | Pide a OpenAI que no use sus páginas para entrenar modelos futuros | No lo saca de la búsqueda de ChatGPT, que usa OAI-SearchBot |
| OAI-SearchBot | OpenAI | Índice de búsqueda para los resultados de ChatGPT | Pide a OpenAI que no incluya sus páginas en sus funciones de búsqueda | No es un rastreador de entrenamiento; bloquearlo no detendrá el entrenamiento |
| ChatGPT-User | OpenAI | Obtiene una página cuando un usuario o un GPT personalizado la pide | Pide a OpenAI que no abra sus páginas a petición de usuarios | OpenAI indica que las reglas de robots.txt pueden no aplicarse a estas visitas iniciadas por el usuario |
| ClaudeBot | Anthropic | Rastreador de entrenamiento | Pide a Anthropic que no recoja sus páginas para entrenamiento | No cubre Claude-User (peticiones de usuarios) ni Claude-SearchBot (búsqueda): Anthropic los enumera por separado |
| anthropic-ai | Anthropic | Token antiguo de entrenamiento | Token antiguo. La documentación actual de Anthropic enumera ClaudeBot, Claude-User y Claude-SearchBot; mantener anthropic-ai en la lista no hace daño | Muchos sitios lo incluyen por costumbre |
| Google-Extended | Un token de robots.txt, no un rastreador aparte; controla el uso del contenido para el entrenamiento y el grounding de Gemini | Excluye su contenido de esos usos de Gemini | No cambia el rastreo ni la indexación de Google Search, y Google indica que no gobierna funciones de Búsqueda como AI Overviews | |
| Applebot-Extended | Apple | Un token; controla si el contenido rastreado por Applebot se usa para entrenar los modelos de Apple | Excluye su contenido de ese entrenamiento | Applebot sigue rastreando para la búsqueda de Siri y Spotlight |
| PerplexityBot | Perplexity | Indexa páginas para la búsqueda de Perplexity | Pide a Perplexity que no muestre sus páginas en los resultados | Perplexity dice que no se usa para entrenar modelos fundacionales; las visitas iniciadas por el usuario usan otro agente |
| CCBot | Common Crawl | Construye un archivo abierto de la web que muchos desarrolladores de IA usan para entrenar | Mantiene las páginas nuevas fuera de los futuros conjuntos de Common Crawl | No borra lo que rastreos anteriores ya guardaron |
| Bytespider | ByteDance | Rastreador para productos y modelos de ByteDance | Pide a ByteDance que no rastree el sitio | Algunos operadores de sitios informan de que ignora robots.txt; si eso importa, bloquee también en el servidor o en el CDN |
Cuatro cosas que robots.txt no puede hacer
- Es una petición, no un candado. Un rastreador que se porta bien lo lee; uno que se porta mal, no. Para imponer un bloqueo, use las reglas de su CDN, cortafuegos o servidor web (los 661 sitios que respondieron a nuestro rastreador con una página de bloqueo de WAF usan esta herramienta más fuerte).
- No es retroactivo. Afecta al rastreo futuro. El contenido que un rastreador ya recogió, o que está en un archivo antiguo de Common Crawl, sigue donde estaba.
- Entrenamiento y respuestas son interruptores separados. Bloquear los bots de entrenamiento (GPTBot, ClaudeBot, Google-Extended) es una decisión distinta de bloquear los bots que deciden si su página puede citarse en una respuesta de IA (OAI-SearchBot, PerplexityBot). En nuestros datos, el 8,4% de los sitios bloquea solo bots de entrenamiento, el 6,6% bloquea ambos grupos y solo 4 sitios bloquean únicamente los bots de consulta.
- No oculta una página de Google Search. Google-Extended es independiente de Googlebot. Bloquear el primero deja intacto el rastreo de búsqueda habitual, mientras que un
Disallow: /general o un bloqueo de Googlebot cierran el sitio a la búsqueda.
Dónde se dividen los sitios: entrenamiento frente a consulta
Tomemos OpenAI. De los 549 sitios que bloquean GPTBot, 249 (45,4%) bloquean también ChatGPT-User y 167 (30,4%) también OAI-SearchBot; 382 (69,6%) bloquean el rastreador de entrenamiento pero dejan abierto el de búsqueda. Es una política coherente: renunciar al entrenamiento y seguir siendo elegible para aparecer en la búsqueda de ChatGPT. El par de Google se comporta de forma parecida: 121 sitios bloquean GPTBot sin Google-Extended, y 24 bloquean Google-Extended sin GPTBot.
La directiva más reciente Content-Signal expresa la misma división en una sola línea, con valores yes o no separados para search, ai-input y ai-train. Aparece en el 5,4% de los sitios (258). De ellos, 168 (65,1%) bloquean además al menos un bot de IA por nombre, y 90 usan solo la señal. Solo registramos que la directiva existe; que un rastreador concreto la respete depende del rastreador.
llms.txt: cuántos sitios tienen un archivo real
llms.txt es una propuesta de 2024 de un archivo Markdown en /llms.txt que enumera las páginas más útiles de un sitio para los modelos de lenguaje, con descripciones breves; llms-full.txt es la variante más larga con el contenido incluido. No es un estándar oficial y, en el momento de escribir esto, no conocemos ningún gran proveedor de IA que haya confirmado usar estos archivos para consulta o clasificación, así que trátelo como documentación barata para máquinas, no como una palanca de visibilidad. Lo comprobamos de todos modos, porque es la otra mitad de la pregunta “qué le digo a la IA”.
Contamos un “archivo real” solo cuando la dirección responde 200, no es una página HTML y no redirige a otra página. Eso excluye 435 sitios (8,6%) que responden 200 con una página HTML (un soft 404 o un relleno) o una redirección.

| Medida | Sitios | Porcentaje |
|---|---|---|
| Archivo llms.txt real | 1 139 | 22,5% de 5 071 |
| Archivo llms-full.txt real (todos tienen también llms.txt) | 259 | 5,1% de 5 071 |
| 200 con una página HTML de relleno o una redirección (no se cuenta) | 435 | 8,6% de 5 071 |
| 404 | 3 218 | 63,5% de 5 071 |
| llms.txt real entre los sitios que bloquean bots de IA | 112 de 719 | 15,6% |
| llms.txt real entre los que no bloquean (robots.txt encontrado) | 1 019 de 4 053 | 25,1% |
Cómo son los archivos reales: la mediana es de 5 922 bytes y el percentil 90 de 56 975 bytes; el 77,9% empieza con un encabezado (H1), como sugiere el formato; el 89,0% contiene al menos un enlace Markdown (el archivo mediano tiene 24); el 10,3% no tiene ninguno y es, en la práctica, texto plano. El 11,6% se sirve como text/markdown, el resto como text/plain.
La relación con el bloqueo es solo una correlación: los sitios que bloquean bots de IA publican con menos probabilidad un archivo escrito para sistemas de IA (15,6% frente a 25,1%), lo que encaja con una lectura simple: estos sitios eligen no interactuar con la IA y los demás eligen hacerlo. No podemos decir que una cosa cause la otra; algunos archivos proceden de plugins y constructores que los crean automáticamente (la proporción es del 35,3% entre los sitios con otros CMS y constructores, 25,5% en WordPress y 20,6% sin etiqueta generator). Nuestra muestra también está sesgada hacia sitios que aparecen en los resultados de búsqueda.
Por CMS y por idioma
El CMS sale de la etiqueta meta generator; 3 598 de los 4 772 sitios no la publican, y es el grupo más grande y el que más bloquea. No se muestran los grupos de menos de 30 sitios. Nota: los nombres de host de nuestros datos están cifrados con hash, por lo que no es posible un desglose por zona de dominio (TLD); mostramos el idioma de la página declarado en el HTML como la señal geográfica más cercana.

| CMS (etiqueta generator) | Sitios con robots.txt | Bloquean algún bot de IA | Bloquean GPTBot | Archivo llms.txt (de todos los sitios del grupo) |
|---|---|---|---|---|
| Sin etiqueta generator | 3 598 | 17,6% (632) | 13,4% | 20,6% (793 de 3 856) |
| Otro CMS o constructor | 587 | 5,3% (31) | 4,6% | 35,3% (218 de 618) |
| WordPress | 462 | 9,3% (43) | 7,1% | 25,5% (120 de 471) |
| Drupal | 47 | 19,1% (9) | 8,5% | 10,6% (5 de 47) |
| MediaWiki | 42 | 4,8% (2) | 2,4% | 2,4% (1 de 42) |
| Joomla | 36 | 5,6% (2) | 2,8% | 5,4% (2 de 37) |
Lea la división por CMS con cuidado. Los sitios sin etiqueta generator suelen ser desarrollos a medida, tiendas y sitios comerciales grandes, y esos propietarios son los que más probablemente tienen una política; los sitios en plataformas ya hechas suelen conservar el robots.txt por defecto de la plataforma. La diferencia tiene que ver tanto con quién gestiona el sitio como con el software que usa. Los grupos de Drupal y MediaWiki son pequeños (47 y 42 sitios).
| Idioma del HTML | Sitios con robots.txt | Bloquean algún bot de IA | Bloquean GPTBot |
|---|---|---|---|
| en | 1 655 | 12,6% (208) | 8,6% |
| ru | 823 | 7,2% (59) | 4,5% |
| uk | 516 | 10,1% (52) | 5,6% |
| sin idioma declarado | 505 | 34,7% (175) | 32,7% |
| sv | 336 | 13,7% (46) | 11,3% |
| de | 311 | 19,6% (61) | 17,4% |
| pl | 102 | 16,7% (17) | 9,8% |
| he | 89 | 11,2% (10) | 5,6% |
| es | 85 | 22,4% (19) | 20,0% |
| fr | 72 | 13,9% (10) | 11,1% |
| nl | 35 | 14,3% (5) | 2,9% |
Los sitios en alemán y en español de esta muestra bloquean con más frecuencia que los sitios en inglés, ruso y ucraniano. El grupo sin idioma declarado destaca con un 34,7%, más del doble de la media de la muestra; no hemos analizado el motivo. Tome la tabla de idiomas como una descripción de esta muestra, no como una estadística nacional: la muestra procede de las consultas de búsqueda que seguimos.
Cómo decidir para su sitio
No existe un ajuste correcto para todos. La decisión depende de lo que quiera de los sistemas de IA: que lo encuentren y lo citen, mantener el contenido fuera del entrenamiento, o ambas cosas a la vez. Use la tabla como punto de partida y luego pruebe el resultado.
| Su situación | Postura razonable en robots.txt | Qué vigilar |
|---|---|---|
| Quiere aparecer en respuestas y búsquedas de IA (negocio de servicios, negocio local, B2B, tienda) | Permita OAI-SearchBot, PerplexityBot y ChatGPT-User; permita los bots de entrenamiento o déjelos sin mencionar | Bloquear los bots de búsqueda lo saca del grupo que podría citarlo; no copie por accidente una lista de “bloquear todo” |
| No le importa que lo encuentren, pero no quiere que su texto se use para entrenar | Bloquee GPTBot, ClaudeBot (y anthropic-ai si quiere), CCBot, Google-Extended, Applebot-Extended; deje permitidos los bots de búsqueda y de usuario | No es retroactivo; algunos rastreadores pueden ignorarlo; es la política que sigue el 8,4% de los sitios de nuestros datos |
| Contenido de pago o solo para miembros, investigación original, archivo de medios | Bloquee todos los bots de entrenamiento, decida caso por caso sobre los de consulta y haga cumplir la regla con CDN o cortafuegos, no solo con robots.txt | Robots.txt no detiene a un rastreador que lo ignora; revise los registros del servidor |
| No quiere nada de los sistemas de IA | Bloquee los diez bots seguidos (lo hace el 13,2% de los sitios que bloquean) y añada reglas a nivel de servidor | No use un Disallow: / general para *: cierra el sitio también a los buscadores |
| Aún no tiene una política clara | Deje todo como está, añada una línea Sitemap, anote qué bots visitan su servidor y vuelva a revisarlo en un trimestre | Una lista copiada sin revisar es la fuente más común de bloqueos accidentales |
Una lista de comprobación breve:
- Abra su propio
/robots.txty busque los diez nombres de arriba. Nuestro analizador de robots.txt gratuito interpreta el archivo y muestra qué reglas se aplican a qué bot. - Escriba la política en una frase (por ejemplo, “permitir los bots de búsqueda y respuesta, rechazar el entrenamiento”) y construya el archivo a partir de ella. El generador de robots.txt crea los grupos por usted.
- Asegúrese de no haber bloqueado Googlebot por accidente: las reglas de IA deben nombrar los user agents de IA, no
*. - Si publica un llms.txt, trátelo como documentación: un título, un resumen breve y una lista de páginas clave con descripciones de una línea, servido como texto plano o Markdown con estado 200. No tenemos una herramienta para ello, y una página de relleno que devuelve 200 es peor que un 404 porque los rastreadores no pueden distinguirla de un archivo.
- Revise la política cuando un proveedor cambie su documentación; los nombres de los user agents cambian (anthropic-ai es un ejemplo).
Metodología y advertencias
Los datos proceden de nuestro propio rastreo TRI de 6 000 sitios el 15 y 16 de noviembre de 2026: el corpus de sitios que aparecen en los resultados de Google para las consultas que seguimos, más sitios de usuarios y una muestra de control. Los nombres de host de la exportación se sustituyen por hashes y solo publicamos agregados. Excluimos 661 sitios (11,0%) que respondieron al rastreador con una página de protección contra bots (WAF; 420 de ellos Cloudflare), 178 sitios inaccesibles (3,0%) y 90 con otros errores de servidor o HTTP (1,5%). Los 655 sitios bloqueados por WAF que volvimos a intentar siete días después estaban bloqueados de nuevo. El cálculo abarca 5 071 sitios; se encontró robots.txt en 4 772 (94,1%) y los porcentajes de las secciones de robots usan esos 4 772. Los porcentajes de llms.txt usan los 5 071.
Un sitio “bloquea” un bot cuando el robots.txt analizado prohíbe al user agent del bot todo el sitio (Disallow: /). Los diez user agents son los de la tabla del ranking. Los bloqueos parciales (una carpeta) no se cuentan como bloqueos. Content-Signal y un Disallow: / general para todos los rastreadores se cuentan por separado. El criterio de “archivo real” de llms.txt es: estado 200, contenido que no sea HTML, sin redirección a otra página.
Límites:
- La muestra no es aleatoria. Se construye con sitios que aparecen en los resultados de búsqueda de nuestras consultas, así que se inclina hacia sitios activos en SEO. No traslade los porcentajes a toda la web.
- Los sitios tras un WAF están excluidos, y probablemente sean sitios más protegidos y más grandes; su política de robots.txt puede ser distinta.
- Robots.txt muestra la intención del propietario, no si un bot la cumple.
- Leemos las reglas en una sola instantánea; los sitios cambian sus archivos y los proveedores de IA añaden y renombran rastreadores. Seguimos diez user agents y no cubrimos otros (por ejemplo, los agentes separados más recientes que algunos proveedores documentan para peticiones de usuarios).
- El CMS sale de la etiqueta meta generator, que la mayoría de los sitios no publica; el idioma sale del atributo
langdel HTML. El desglose por zona de dominio (TLD) no está disponible porque los nombres de host están cifrados con hash. - Las correlaciones (bloqueo y llms.txt, CMS y bloqueo) no son causas.
Dos notas sobre las cifras. Nuestro borrador de trabajo del 16.11 describía 379 sitios como que bloqueaban “los 7 bots principales”; el recuento final es de 379 sitios que bloquean siete o más de los diez bots seguidos, de los cuales 95 bloquean los diez. El borrador también comparaba 15,6% con 23,6% para llms.txt, donde la segunda cifra usaba todos los sitios sin bloqueos de IA, incluidos los que no tienen robots.txt; aquí la base es la misma (sitios con robots.txt), lo que da 25,1%.
FAQ
¿Debo bloquear los bots de IA en robots.txt?
Depende de lo que quiera. Si quiere que lo citen en las respuestas de IA, mantenga permitidos los bots de búsqueda (OAI-SearchBot, PerplexityBot). Si se opone a que su texto se use para entrenar, bloquee los bots de entrenamiento (GPTBot, ClaudeBot, Google-Extended, CCBot, Applebot-Extended). En nuestra muestra de 4 772 sitios con robots.txt, el 15,1% bloquea al menos un bot de IA y el 8,4% bloquea solo bots de entrenamiento.
¿Desaparezco de ChatGPT si bloqueo GPTBot?
No. GPTBot es el rastreador de entrenamiento de OpenAI. Los resultados de búsqueda de ChatGPT usan OAI-SearchBot y las peticiones de usuarios usan ChatGPT-User. De los 549 sitios de nuestros datos que bloquean GPTBot, el 69,6% deja abierto OAI-SearchBot.
¿Bloquear Google-Extended afecta a mis posiciones en Google?
Google documenta Google-Extended como un token independiente que controla el uso del contenido para Gemini; no forma parte de Googlebot y no gobierna el rastreo ni la indexación de la Búsqueda. No afirmamos ningún efecto en las posiciones, ni positivo ni negativo.
¿Los bots de IA respetan robots.txt?
Los grandes proveedores dicen que sus rastreadores lo hacen, con la salvedad de que OpenAI indica que las visitas de ChatGPT-User iniciadas por el usuario pueden no seguirlo. Robots.txt es un estándar voluntario, y algunos propietarios de sitios informan de rastreadores que lo ignoran. Para imponer un bloqueo, use las reglas de su CDN o servidor.
¿Necesito un archivo llms.txt?
Ningún proveedor lo exige y no conocemos un uso confirmado por parte de un gran sistema de IA. El 22,5% de los 5 071 sitios que comprobamos publica uno. Es barato de añadir e inofensivo si se mantiene exacto, pero no espere que cambie la visibilidad.
¿Cómo puedo comprobar qué bots de IA bloquea mi sitio?
Abra /robots.txt y busque los user agents citados en este artículo, o pegue el archivo en nuestro analizador de robots.txt. Para crear un archivo nuevo, use el generador de robots.txt.
Fuentes
- OpenAI, Overview of OpenAI crawlers: platform.openai.com/docs/bots
- Anthropic, artículo de ayuda sobre el rastreador y robots.txt: support.anthropic.com
- Google Search Central, Google's common crawlers (Google-Extended): developers.google.com
- Apple, About Applebot: support.apple.com/en-us/119829
- Perplexity, Perplexity crawlers: docs.perplexity.ai/guides/bots
- Common Crawl, CCBot: commoncrawl.org/ccbot
- IETF, RFC 9309, Robots Exclusion Protocol: rfc-editor.org/rfc/rfc9309
- Propuesta llms.txt: llmstxt.org
- Content Signals Policy: contentsignals.org
Cómo citar
PromoPilot (2026). Cuántos sitios bloquean bots de IA en robots.txt: 5 071 sitios, noviembre de 2026. Datos del 15 y 16 de noviembre de 2026. CC BY 4.0: https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-robots-5071-sites-2026-11.csv . Artículo: https://promopilot.link/es/blog/cuantos-sitios-bloquean-bots-de-ia-en-robots-txt-5071-sitios-2026
Descargar los datos
Las tablas agregadas (CSV, licencia CC BY 4.0): https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-robots-5071-sites-2026-11.csv, además de las tablas https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-blocked-count-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-bot-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-cms-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-html-lang-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/llms-txt-by-cms-2026-11.csv. Contiene solo agregados, sin proyectos, dominios ni datos de clientes.