Невидимі символи в текстах ChatGPT: тест 8 нейромереж і водяний знак textGrain (2026)
Власний тест 8 нейромереж (GPT-5.6, o3, Claude, Gemini, DeepSeek, Grok, Mistral): чи ставлять вони невидимі символи, як працює водяний знак OpenAI textGrain і як перевірити текст перед публікацією за 5 хвилин.
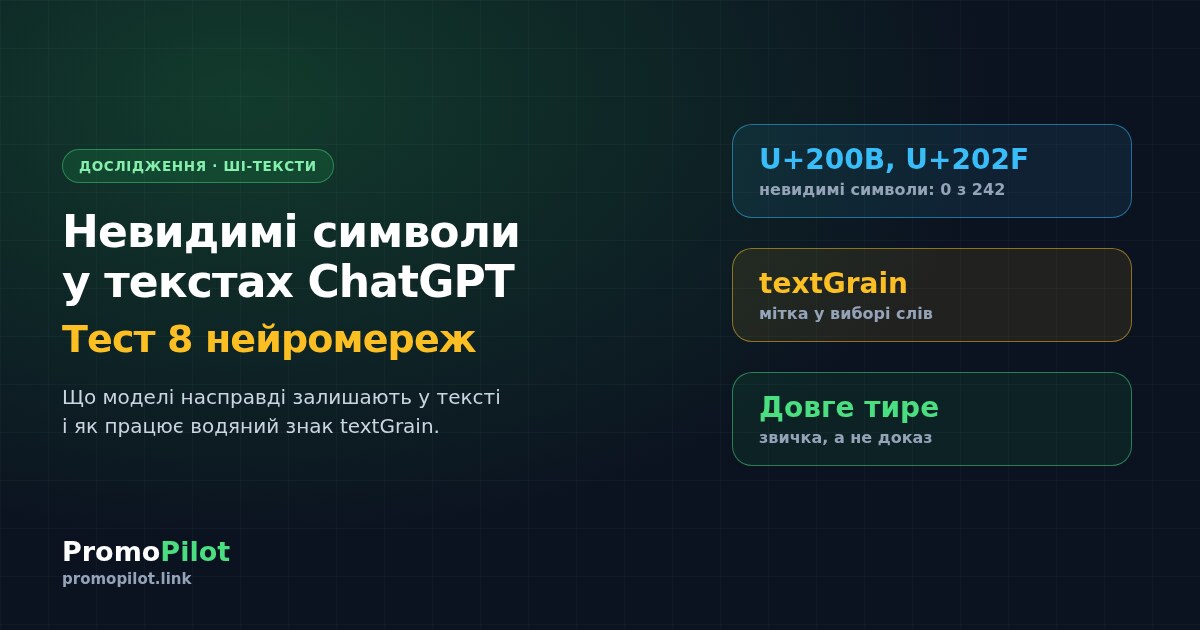
Невидимих символів у текстах ChatGPT та інших нейромереж сьогодні немає: у нашому тесті 8 моделей дали 242 відповіді, 264 831 символ, і жодного U+200B, U+202F чи м’якого переносу. Історія про «приховані водяні знаки з пробілів» народилася навесні 2025 року й відтоді живе окремо від фактів. Справжній водяний знак OpenAI з’явився лише 5 жовтня 2026 року, називається textGrain і схований не в символах, а у виборі слів, тому жоден «очищувач Unicode» його не бачить і не прибирає. Нижче наш вимір, цифри OpenAI щодо стійкості мітки та протокол перевірки тексту перед публікацією.
Коротко
- Невидимих символів немає. 242 відповіді восьми моделей (GPT-5.6 Luna, GPT-4o, o3, Claude Sonnet 5.5, Gemini 3.8 Flash, DeepSeek V4.1 Flash, Grok 4.7, Mistral Large 4): нуль символів форматування Unicode і нуль нестандартних пробілів. Зокрема в 63 відповідях на завдання з числами, валютами й датами, де раніше й знаходили U+202F.
- Водяний знак OpenAI є, але він у словах. textGrain трохи зміщує вибір слів і утворює статистичний візерунок. За даними OpenAI, без правок мітку знаходять приблизно у 92% випадків, після заміни 25% слів синонімами лише у 17%.
- Що справді видає текст нейромережі. Довге тире в англійській, «розумні» лапки, залишки розмітки Markdown. Доказом нічого з цього не є.
- Звідки тоді невидимі символи у ваших текстах. Найчастіше з копіювання: вебсторінки, месенджери, текстові редактори, емодзі. Перевірити й прибрати їх можна за хвилину.
Звідки взялася історія про «приховані пробіли»
У квітні 2025 року американський стартап Rumi, який робить інструменти для університетів, повідомив: у текстах моделей o3 та o4-mini трапляється вузький нерозривний пробіл U+202F. Виглядає він як звичайний пробіл, але код у нього інший, тож простий пошук його знаходить. Новина швидко перетворилася на «OpenAI таємно позначає тексти», а в мережі з’явилися десятки «видалювачів водяних знаків ChatGPT».
Офіційної заяви OpenAI про те, що це був водяний знак, ми не знайшли. Є й буденніше пояснення: вузький нерозривний пробіл за правилами типографіки ставлять між числом і одиницею виміру, між ініціалами, перед знаками в деяких мовах. Модель могла вивчити це з навчальних текстів. Та й сам Rumi називав знахідку, найімовірніше, тимчасовою.
Ми окремо протестували o3: 19 відповідей, зокрема завдання із сумами, відсотками й датами. U+202F не знайшовся жодного разу. Що б це не було навесні 2025 року, зараз цього немає.
Що змінилося в жовтні 2026: водяний знак textGrain
5 жовтня 2026 року OpenAI оголосила про водяний знак textGrain для тексту. Головне з анонсу (за публікацією BleepingComputer у день оголошення):
- Як працює. Модель трохи зміщує вибір між відповідними словами й частинами слів. Виходить статистичний візерунок, якого читач не помічає, а детектор знаходить. Прихованих символів, невидимих пробілів і незвичної пунктуації мітка не додає, тож під час копіювання нічого «зайвого» не переноситься.
- Де ввімкнено. У ChatGPT і Codex для користувачів із Євросоюзу на всіх тарифах, розгортання протягом кількох тижнів. В API в усьому світі вмикається за бажанням розробника в налаштуваннях проєкту чи організації, за замовчуванням вимкнено.
- Хто може перевірити. Детектор поки видають лише схваленим дослідникам та експертним організаціям, за заявками. Публічної перевірки «на textGrain» немає, і будь-який сервіс, що сьогодні обіцяє її зробити, каже неправду.
- Чого мітка не доводить. OpenAI прямо пише, що відсутність знайденої мітки не доводить, що текст написала людина. Знайдена мітка теж не каже, хто згенерував текст і наскільки його потім правили.
Цифри стійкості чесні й показові. Для відповіді довжиною 400 токенів (приблизно 300 слів) мітку знаходять приблизно у 92% випадків. Заміна 10% слів синонімами знижує виявлення до 66%, заміна 25% до 17%. Короткі, сильно переписані й перекладені тексти, за словами OpenAI, перевіряються погано, а в математиці, де в моделі мало свободи у виборі слів, мітка слабша.
Схожий підхід у Google: SynthID Text додає статистичну мітку у вибір слів, і 2024 року Google відкрила його код. Чому такі мітки з’являються саме зараз і саме в ЄС: європейський закон про ШІ (AI Act, стаття 50) вимагає від постачальників генеративних систем позначати синтетичний контент у машинозчитуваному вигляді, і запуск textGrain у публікаціях пов’язують саме з цим.
Наш тест: як ми перевіряли
26 жовтня 2026 року ми дали восьми моделям однакові завдання й порахували у відповідях усі незвичні символи. Моделі викликалися через API (OpenRouter), температура 0,7, без системних інструкцій:
- Моделі: GPT-5.6 Luna, GPT-4o та o3 (OpenAI), Claude Sonnet 5.5 (Anthropic), Gemini 3.8 Flash (Google), DeepSeek V4.1 Flash, Grok 4.7 (xAI), Mistral Large 4.
- Завдання: шість типових текстів для сайту й пошти (вступ до статті, порада щодо вибору хостингу, опис товару, лист клієнтові, поради щодо метаописів, плюси й мінуси віддаленої роботи) російською та англійською, кожне двічі. Плюс чотири завдання з числами, валютами, одиницями виміру й датами, де вузький пробіл з’явився б насамперед.
- Що вважали невидимим: усі символи форматування Unicode (категорія Cf: U+200B, U+200C, U+200D, U+2060, U+FEFF, керування напрямком тексту та інші), м’який перенос U+00AD і всі пробіли, крім звичайного: нерозривний U+00A0, вузький U+202F, тонкий U+2009 та інші.
- Окремо рахували «типографіку»: довге тире, «розумні» лапки, розмітку Markdown.
Разом 242 відповіді (у Qwen більшість відповідей повернулася порожньою, його ми з вибірки прибрали, для o4-mini провайдер повернув помилку). Це не мільйонна вибірка, але для питання «чи ставлять моделі невидимі символи» її досить: якби символ з’являвся хоча б у кожній двадцятій відповіді, ми б побачили його з імовірністю понад 99,9%.
Результат 1: невидимих символів немає в жодної моделі
Нуль із 242. Жодного символу нульової ширини, жодного м’якого переносу, жодного нерозривного чи вузького пробілу, зокрема в 63 відповідях із сумами («4,5 млн доларів», «$6.2 million»), відсотками, температурами й датами. Жодна модель, включно з o3, не ставить пробіли «за правилами типографіки» сама.
Важливе застереження: ми перевіряли відповіді API, тобто текст, який модель віддає розробникові. Вебчат додає до нього оформлення, а далі все залежить від того, куди й як ви копіюєте. Саме на цьому кроці, а не в самій моделі, у текст найчастіше й потрапляє «невидиме». Про це нижче.
Результат 2: справжні прикмети видно оком
Якщо щось і видає текст нейромережі, то видимі звички. Найбільш обговорювана з них довге тире.
Головне тут порівняння в межах мови. У російській (як і в українській) довге тире звичайна пунктуація, його ставить будь-який грамотний автор, тому 58% російських відповідей із тире нічого не означають. В англійській em dash трапляється рідше, і там розкид між моделями помітний: від 0% у Claude Sonnet 5.5 до 44% у Mistral Large 4 та o3. Але й це стиль, а не доказ: багато авторів пишуть із тире самі.
Друга звичка «розумні» лапки в англійському тексті (“…” замість "…"). GPT-5.6 Luna ставить їх у 10 відповідях із 16, o3 у 7 із 9, а Claude Sonnet 5.5 жодного разу. Третя розмітка Markdown.
Зірочки й решітки самі собою нешкідливі, але якщо текст копіюють не з чату, а з відповіді API чи із сервісу-посередника, вони лишаються в тексті як є: «**Важливо:**» посеред абзацу видає генерацію краще за будь-який детектор.
Звідки тоді невидимі символи в реальних текстах
Наш детектор прихованих символів лише з 13 по 26 жовтня перевірив понад 600 текстів, і незвичні символи в реальних текстах трапляються регулярно. Але, судячи з нашого тесту, приходять вони не з моделі, а дорогою:
| Символ | Код | Звідки зазвичай береться | Чим заважає |
|---|---|---|---|
| Нерозривний пробіл | U+00A0 | Копіювання з вебсторінок ( ), Word і Google Docs, автозаміна перед знаками | Зазвичай нічим; ламає пошук і порівняння рядків |
| Пробіл нульової ширини | U+200B | Верстка сайтів (переноси довгих слів), деякі месенджери й CMS | Слово виглядає так само, але не знаходиться пошуком; в адресі сторінки дає інший URL |
| З’єднувач нульової ширини | U+200D | Емодзі з кількох частин (родина, прапори, професії) | Лишається «хвостом», якщо емодзі видалити не повністю |
| Мітки напрямку | U+200E, U+200F, U+202A–U+202E | Тексти, де змішано мови з різним напрямком письма | Дивний порядок символів, ламають копіювання адрес і коду |
| Мітка порядку байтів | U+FEFF | Файли, збережені в UTF-8 з BOM (старий Блокнот Windows, вивантаження) | Ламає JSON, CSV і конфіги, якщо стоїть на початку файлу |
| М’який перенос | U+00AD | Автоматичне розставлення переносів у редакторах і верстці | Слово розривається під час пошуку й підрахунку |
Докладніше про кожен символ і як знайти його вручну в довідці «Сховані водяні знаки та невидимі символи в тексті», а порівняння безкоштовних сервісів в огляді «Невидимі символи в тексті: безкоштовні сервіси».
Чи важливо це для SEO
Для позицій сам факт генерації не вирішальний. В оновлених 1 жовтня 2026 року рекомендаціях Google щодо ШІ-контенту акцент на іншому: вміст має бути корисним, а факти в тексті, згенерованому ШІ, треба перевіряти вручну до публікації, включно з метаданими. Про те, що пошук шукає в текстах невидимі символи чи водяні знаки нейромереж, Google не повідомляв.
Невидимі символи шкодять інакше, суто технічно:
- У заголовках і метатегах символ нульової ширини робить рядок «іншим»: дублі не знаходяться, пошук по сайту не спрацьовує, під час копіювання з видачі виходить сміття.
- В адресах і якорях U+200B перетворюється на
%E2%80%8B, і посилання веде на іншу адресу, зазвичай на 404. - У розмітці та файлах BOM на початку JSON-LD, CSV-фіду чи конфігу ламає розбір повністю.
- У тексті статті м’які переноси й нульові пробіли заважають пошуку по сторінці, підрахунку слів і перевірці на унікальність.
Тому чистити текст варто не «від водяних знаків ChatGPT», а як звичайну гігієну перед публікацією, неважливо, хто його написав.
Протокол: перевірка тексту перед публікацією за 5 хвилин
Знайдіть невидимі символи
Вставте текст у детектор прихованих символів. Він покаже кожен незвичний символ із кодом і позицією, а не просто «щось знайдено».
Приберіть зайве, не чіпаючи потрібного
Очистіть текст у видалювачі невидимих символів. Нерозривний пробіл між числом і одиницею («10 км») цілком доречний, а нульові пробіли й BOM у тексті для сайту не потрібні.
Видаліть залишки розмітки
Пошукайте в тексті **, ## і рядки, що починаються з - . Якщо текст вставляється в CMS як звичайний абзац, розмітка лишиться видимою.
Приведіть типографіку до своєї редполітики
Вирішіть один раз і для всіх текстів: які лапки, яке тире, чи потрібні нерозривні пробіли. Не треба «вичищати» тире з українського чи російського тексту: це норма мови, а не слід нейромережі.
Перевірте факти вручну
Саме цього Google чекає від текстів, створених за допомогою ШІ: цифри, дати, назви, цитати звіряються з першоджерелом до публікації. Жоден детектор цей крок не замінить.
Чого не робити
Якщо треба перевірити саме зображення, відео чи звук, це інша історія: там працюють метадані C2PA і SynthID. Розбирали її в статті «Детектор водяних знаків ШІ: SynthID, C2PA і метадані».
Питання та відповіді
Чи додає ChatGPT невидимі символи в текст?
У нашому тесті 26.10.2026 ні: 242 відповіді восьми моделей, зокрема GPT-5.6, GPT-4o та o3, без жодного символу нульової ширини чи особливого пробілу. Водяний знак OpenAI textGrain працює через вибір слів і, за словами компанії, символів не додає.
Чи можна перевірити текст на водяний знак textGrain?
Поки ні. Детектор OpenAI видає лише схваленим дослідникам та організаціям. Сервіси, які обіцяють таку перевірку, насправді шукають невидимі символи або оцінюють стиль.
Звідки в моєму тексті символи U+200B і U+00A0, якщо я їх не ставив?
Найчастіше з копіювання: з вебсторінок, месенджерів, Word і Google Docs. U+200D приходить разом зі складеними емодзі. Перевірити й прибрати їх можна безкоштовним детектором прихованих символів.
Чи видає довге тире текст нейромережі?
Саме собою ні. У російських відповідях моделей тире стоїть у 58% випадків, бо це звичайна пунктуація, так само пишуть люди. В англійській моделі ставлять em dash помітно частіше за середнього автора, але це стилістична звичка, а не доказ.
Чи знижує Google тексти, написані ШІ?
Google оцінює користь і точність, а не спосіб створення. З 1 жовтня 2026 року в його рекомендаціях прямо сказано, що факти в тексті, згенерованому ШІ, треба перевіряти вручну до публікації. Про пошук невидимих символів чи водяних знаків Google не повідомляв.
Джерела: власний тест PromoPilot 26.10.2026 (8 моделей, 242 відповіді через OpenRouter API); BleepingComputer, «OpenAI is adding invisible watermarks to ChatGPT and Codex text in the EU», 05.10.2026; довідка OpenAI «Provenance signals in OpenAI-generated content»; публікації про знахідку Rumi, квітень 2025; Регламент ЄС 2024/1689 (AI Act), стаття 50; рекомендації Google Search Central щодо ШІ-контенту, редакція 01.10.2026. Матеріал підготувала команда PromoPilot.