JSON-LD po zmianie Google: sprawdziliśmy 1 044 witryny — dotknęło 1,6%, a prawdziwy problem ma jedna trzecia
Od 21 sierpnia Google zdejmuje kodowanie HTML ze znaczników JSON-LD raz zamiast dwóch. Sprawdziliśmy 3 167 stron z 1 044 witryn: zmiana dotknęła tylko 1,6% z nich. Za to 23% witryn na Shopify ma w znacznikach znaki, których nie zdekoduje żaden parser zgodny ze standardem, a 36% witryn z topu Google zapisuje znaczniki tak, że poprawnie czyta je tylko Google. Omawiamy przyczyny, nasz własny błąd i cztery kroki sprawdzenia.
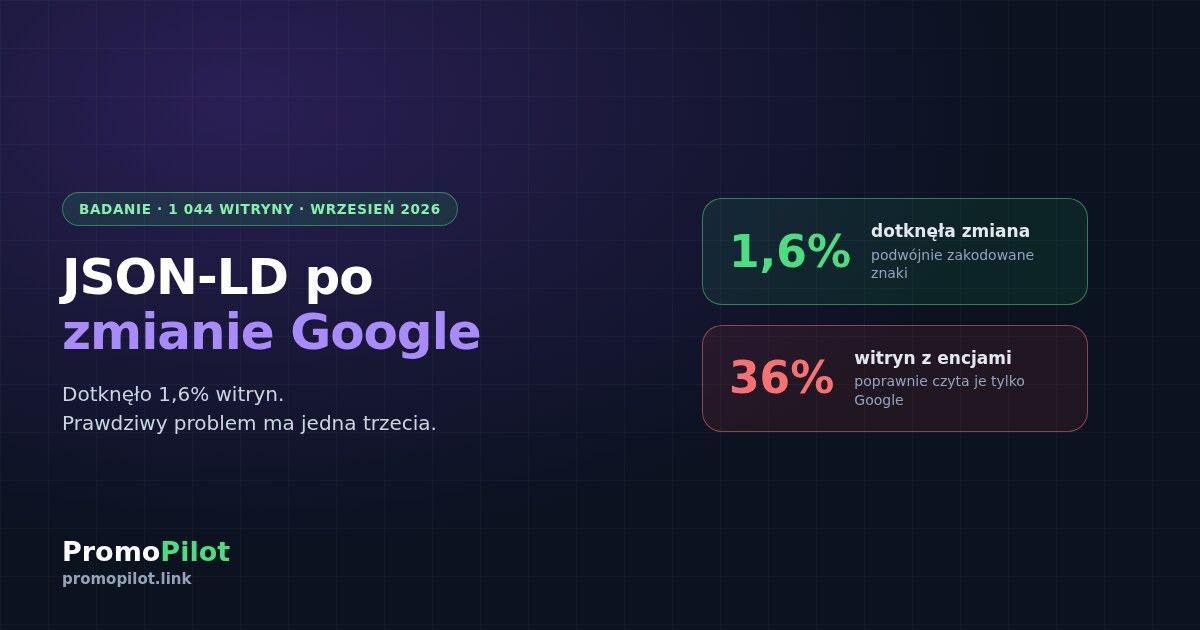
21 sierpnia Google zmienił sposób, w jaki jego robot odczytuje znaczniki JSON-LD, a media branżowe zgodnie napisały „pilnie sprawdźcie swoje znaczniki”. Sprawdziliśmy — nie swoje, lecz 1 044 witryny: 748 z pierwszej dziesiątki Google dla zapytań komercyjnych, 295 witryn naszych klientów i naszą własną. Łącznie 3 167 stron. Zmiana Google dotknęła 1,6% witryn. Za to znalazł się problem dwadzieścia razy szerszy, o którym nikt nie pisze — i jeden błąd u nas samych, który już naprawiliśmy.
Co dokładnie zmienił Google
Ogłoszenie ukazało się nie w dokumentacji, lecz jako wpis Google Search Central na LinkedIn. Kluczowe zdanie:
„We changed our JSON-LD extraction and are now only applying a single pass of HTML unescaping”.
Google Search Central, LinkedIn, 21 sierpnia 2026Żeby zrozumieć, o co chodzi, potrzebny jest jeden fakt o HTML. W zwykłym tekście strony ampersand zapisuje się jako &, a przeglądarka pokazuje go jako „&”. Ale zawartość znacznika <script> — a właśnie tam żyją znaczniki JSON-LD — według specyfikacji HTML jest „surowym tekstem”: encje HTML nie są tam w ogóle dekodowane. Specyfikacja JSON-LD mówi o tym wprost: takie znaki „pozostaną zakodowane po przetworzeniu”.
Google zawsze był tu wyrozumiały i sam dekodował encje. Do sierpnia — dwa razy z rzędu, więc nawet podwójnie zakodowany &amp; zamieniał się w czysty „&”. Teraz — raz. Oto co to oznacza na przykładzie nazwy firmy:
| Zapisane w znacznikach | Google przed 21.08 | Google teraz | Parser zgodny ze standardem |
|---|---|---|---|
Tom & Jerry | Tom & Jerry | Tom & Jerry | Tom & Jerry |
Tom &amp; Jerry | Tom & Jerry | Tom & Jerry | Tom &amp; Jerry |
Tom \u0026 Jerry | Tom & Jerry | Tom & Jerry | Tom & Jerry |
Tom & Jerry | Tom & Jerry | Tom & Jerry | Tom & Jerry |
Zmiana dotyczy tylko drugiego wiersza — podwójnego kodowania. Pierwszy wiersz w Google nadal działa, ale tylko w Google. Dwa ostatnie są poprawne dla wszystkich.
Jak sprawdzaliśmy
Trzy próby. Pierwsza — 2 076 stron z pierwszej dziesiątki Google i ze źródeł odpowiedzi AI dla 48 zapytań komercyjnych z naszego badania rekomendacji AI: to witryny, które naprawdę dostają ruch z drogich zapytań. Druga — witryny naszych klientów: strona główna i do czterech promowanych stron z każdej, żeby duże witryny nie przeważyły. Trzecia — 300 losowych stron naszej własnej witryny. Wszystkie strony pobrano bezpośrednio, bez płatnych usług.
Na każdej stronie wyciągnęliśmy wszystkie bloki JSON-LD i przepuściliśmy je na trzy sposoby: tak, jak Google czytał wcześniej, jak czyta teraz i jak wymaga standard. Wynik liczymy według witryn, a nie stron: strony z jednego szablonu powtarzają jeden błąd, a liczenie po stronach mocno go zawyża. Na przykład prawie połowa stron z podwójnym kodowaniem w naszej próbie pochodziła z jednej witryny.
Kogo dotknęła zmiana: 1,6% witryn
Spośród 748 witryn ze znacznikami podwójne kodowanie znalazło się u 12. Ponad połowa z nich to tytuły jednej grupy medialnej: mają wspólny szablon, w którym opis autora jest kodowany dwukrotnie. Dlatego w znacznikach tych witryn w biogramie autora stoi dziś dosłowne „'” zamiast apostrofu. Wśród witryn naszych klientów takie są dwie na 295.
Wniosek jest prosty: jeśli po 21 sierpnia nie widzieliście w Search Console nowych błędów danych strukturalnych, ta zmiana prawie na pewno was nie dotknęła. Alarm w mediach branżowych był nieproporcjonalny do skali.
Większy problem: Shopify i znaki, których nie dekoduje nikt
Jest drugi sposób, żeby zepsuć znak, i Google nie ma z nim nic wspólnego. Encja trafia do wnętrza escapowania JSON: w kodzie stoi \u0026amp;. Dekodowanie HTML jej nie widzi — w tekście nie ma ampersandu — a po parsowaniu JSON w wartości zostaje dosłowne „&”. Żaden parser zgodny ze standardem tego śmiecia nie usunie.
Znaleźliśmy to u 11 z 47 witryn na Shopify w topie Google — to 23%. Na wszystkich innych platformach — u 2,3%. Dziesięciokrotna różnica. Nie chodzi o samą platformę, tylko o szablony motywów: tekst najpierw koduje się dla HTML, a potem jeszcze raz pakuje filtrem w JSON, i encja przechodzi na wylot. Najczęściej cierpi opis produktu — przychodzi z edytora wizualnego już z encjami w środku.
Największy problem: jedna trzecia witryn pisze znaczniki „tylko dla Google”
U 36% witryn z topu Google i u 23% witryn naszych klientów wewnątrz JSON-LD są zwykłe encje HTML: &, ", '. Google nadal je rozumie — wystarcza jedno przejście dekodowania. Ale to jedyny, kto robi tak z własnej woli. Standard wymaga czytania ich dosłownie, więc każdy inny odbiorca znaczników — inne wyszukiwarki, walidatory, serwisy zbierające dane o produktach i firmach według specyfikacji — zobaczy w nazwie „Tom & Jerry”.
Prawie wszystkie te znaki można bezpiecznie zapisywać w JSON bez zmian: ampersand, cudzysłowy drukarskie i apostrof. Zwykłe proste cudzysłowy wewnątrz łańcucha JSON zabezpiecza się ukośnikiem wstecznym, a nie encją HTML. Jedyne, czego wewnątrz znacznika script naprawdę nie wolno, to sekwencje, które przeglądarka weźmie za koniec skryptu. Dla nich, jak radzi Google, jest escapowanie JSON: \u003C zamiast „<” i \u0026 zamiast „&”.
Sprawdziliśmy na sobie — i znaleźliśmy
Nasza witryna ma znaczniki na wszystkich 300 sprawdzonych stronach i podwójnego kodowania nie znaleźliśmy. Ale dwie strony trafiły do klasy „tylko dla Google”: w okruszkach nawigacyjnych tytuł angielskiego artykułu trafiał do znaczników jako „Web 2.0 & Cascade Promotion”.
Przyczyna jest dokładnie ta, przez którą encje najczęściej trafiają do JSON-LD. Szablon strony koduje tytuł do wyświetlenia w HTML, a kod budujący okruszki bierze już zakodowany łańcuch i wkłada go do JSON. Na ekranie wszystko wygląda dobrze, w znacznikach — nie. Naprawiliśmy to 29 września jedną linijką: przed zapakowaniem w JSON łańcuch jest dekodowany z powrotem. Sprawdziliśmy ponownie — zero encji w znacznikach.
Jak sprawdzić i naprawić swoją witrynę
Znajdźcie encje w znacznikach
Otwórzcie kod strony, znajdźcie bloki application/ld+json i poszukajcie w nich znaku ampersand. Każda sekwencja typu &, ", ' lub \u0026amp; wewnątrz tych bloków to powód do poprawki. Sprawdźcie co najmniej po jednej stronie z każdego szablonu: główną, produkt, artykuł, kategorię.
\u0026.Znajdźcie miejsce, gdzie tekst jest kodowany dwa razy
Prawie zawsze przyczyna jest jedna: do JSON trafia łańcuch przygotowany już do wyświetlenia w HTML. Szukajcie w kodzie, skąd biorą się wartości znaczników: tytuł, opis, imię autora. Jeśli przed zapakowaniem w JSON stosuje się do nich kodowanie HTML — to jest właśnie błąd.
// Źle: łańcuch jest już zakodowany dla HTML — encje trafią do JSON-LD
$title = htmlspecialchars($post['title']);
echo json_encode(['headline' => $title]);

// Dobrze: do JSON trafia surowy tekst, a flagi same zamienią & i < na \u0026 i \u003C
echo json_encode(['headline' => $post['title']],
JSON_HEX_TAG | JSON_HEX_AMP | JSON_UNESCAPED_UNICODE);Jeśli witryna działa na Shopify — sprawdźcie motyw
Szukajcie w szablonie znaczników filtra kodującego zastosowanego przed filtrem json oraz opisu produktu, który przychodzi z edytora wizualnego z encjami w środku. Kolejność filtrów jest tu decydująca: dla HTML koduje się to, co wyświetla się na stronie, a do JSON przekazuje się surowy tekst.
\u0026amp;, \u0026quot; ani \u0026#39;.Sprawdźcie wynik narzędziami Google
Przepuśćcie stronę przez test wyników z elementami rozszerzonymi i przez sprawdzanie adresu URL w Search Console. Patrzcie nie tylko na „brak błędów”, ale na same wartości pól: nazwę, opis, imię autora. Właśnie tam widać dosłowne „&”, którego walidator nie uznaje za błąd.
Najczęstsze pytania
Co dokładnie zmienił Google w parsowaniu JSON-LD 21 sierpnia 2026 roku?
Wcześniej Google zdejmował kodowanie HTML ze znaczników dwa razy, teraz robi to raz. Dlatego podwójnie zakodowany znak, na przykład ampersand zapisany jako encja encji, trafia teraz do wartości nie jako znak, lecz jako tekst encji. Zwykłe, jednokrotnie zakodowane encje Google nadal rozumie.
Jak sprawdzić, czy zmiana dotknęła moją witrynę?
Otwórzcie kod strony i poszukajcie wewnątrz bloków JSON-LD encji zapisanych dwukrotnie: po ampersandzie jest słowo amp, a potem kolejna encja. W naszym sprawdzeniu znalazło się to tylko u 1,6% witryn z topu Google i u 0,7% witryn klientów, przy czym ponad połowa przypadków to jeden szablon jednej grupy medialnej.
Czy trzeba usuwać encje HTML ze znaczników, skoro Google je rozumie?
Tak, jeśli zależy wam na tym, żeby znaczniki były poprawnie czytane nie tylko przez Google. Standard JSON-LD wymaga traktowania takich encji dosłownie i każdy parser zgodny ze specyfikacją zobaczy w wartości tekst encji zamiast znaku. W naszym sprawdzeniu tak zapisane są znaczniki u 36% witryn z topu Google.
Jak poprawnie zapisać ampersand i cudzysłowy w JSON-LD?
Najprościej bez zmian: wewnątrz znacznika script ampersand, apostrof i cudzysłowy drukarskie są bezpieczne. Proste cudzysłowy wewnątrz łańcucha zabezpiecza się ukośnikiem wstecznym zgodnie z regułami JSON. Jeśli potrzebna jest pełna ochrona przed przypadkowym zamknięciem znacznika script, użyjcie escapowania JSON: \u0026 dla ampersandu i \u003C dla znaku mniejszości.
Dlaczego na Shopify uszkodzone znaki występują częściej?
Nie z powodu samej platformy, tylko szablonów motywów. Tekst jest najpierw kodowany do wyświetlenia w HTML, a potem pakowany w JSON, i encja ląduje ukryta wewnątrz escapowania JSON. W naszej próbie dotyczy to 23% witryn na Shopify wobec 2,3% na innych platformach.
Czy błąd w JSON-LD wpływa na pozycje?
Bezpośrednio nie: znaczniki odpowiadają za to, jak strona może wyglądać w wynikach i jak dokładnie maszyny rozumieją jej dane. Ale zepsuta wartość trafi do wyniku rozszerzonego, karty produktu albo cudzego systemu czytającego znaczniki właśnie w zepsutej postaci. Poprawka zwykle zajmuje jedną linijkę kodu.
Źródła: wpis Google Search Central na LinkedIn (21 sierpnia 2026), specyfikacja W3C JSON-LD 1.1, sekcja 7.2, specyfikacja HTML (WHATWG) o surowych elementach tekstowych. Dane własne — 3 167 stron z 1 271 witryn pobranych 29 września 2026: top 10 Google dla 48 zapytań komercyjnych, witryny klientów PromoPilot (bez nazw) i 300 stron promopilot.link.