JSON-LD після зміни Google: перевірили 1 044 сайти — зачепило 1,6%, а справжня проблема в третини
З 21 серпня Google знімає HTML-екранування з розмітки JSON-LD один раз замість двох. Ми перевірили 3 167 сторінок з 1 044 сайтів: зміна зачепила лише 1,6% із них. Натомість у 23% сайтів на Shopify у розмітці символи, які не розкодує жоден обробник за стандартом, а в 36% сайтів із топу Google розмітку записано так, що правильно її читає лише Google. Розбираємо причини, нашу власну помилку і чотири кроки перевірки.
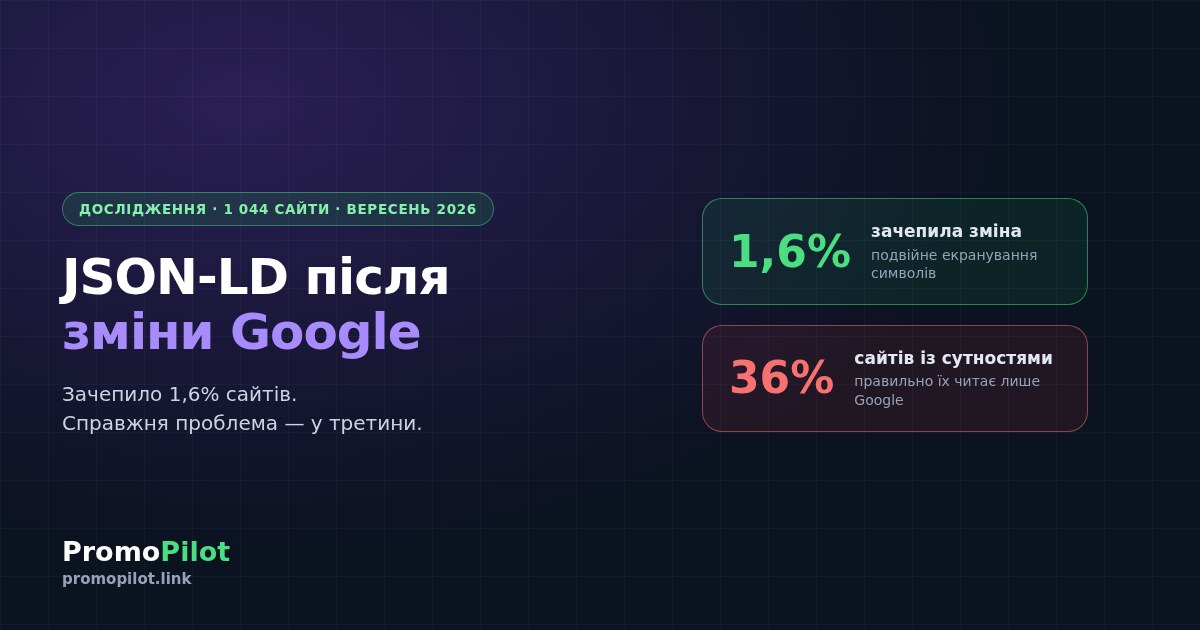
21 серпня Google змінив те, як його робот читає розмітку JSON-LD, і галузеві видання дружно написали «терміново перевірте свою розмітку». Ми перевірили — не свою, а 1 044 сайти: 748 із першої десятки Google за комерційними запитами, 295 сайтів наших клієнтів і наш власний. Загалом 3 167 сторінок. Зміна Google зачепила 1,6% сайтів. Натомість знайшлася проблема вдвадцятеро ширша, про яку не пише ніхто, — і одна помилка в нас самих, яку ми вже виправили.
Що саме змінив Google
Оголошення вийшло не в документації, а дописом Google Search Central у LinkedIn. Ключова фраза:
«We changed our JSON-LD extraction and are now only applying a single pass of HTML unescaping».
Google Search Central, LinkedIn, 21 серпня 2026 рокуЩоб зрозуміти, про що йдеться, потрібен один факт про HTML. У звичайному тексті сторінки амперсанд пишеться як &, а браузер показує його як «&». Але вміст тегу <script> — а розмітка JSON-LD живе саме в ньому — за специфікацією HTML вважається «сирим текстом»: HTML-сутності там не розкодовуються взагалі. Специфікація JSON-LD каже про це прямо: такі символи «залишаться екранованими після обробки».
Google завжди був до цього поблажливим і розкодовував сутності сам. До серпня — двічі поспіль, тож навіть двічі екранований &amp; перетворювався на чистий «&». Тепер — один раз. Ось що це означає на прикладі назви компанії:
| Записано в розмітці | Google до 21.08 | Google зараз | Обробник за стандартом |
|---|---|---|---|
Tom & Jerry | Tom & Jerry | Tom & Jerry | Tom & Jerry |
Tom &amp; Jerry | Tom & Jerry | Tom & Jerry | Tom &amp; Jerry |
Tom \u0026 Jerry | Tom & Jerry | Tom & Jerry | Tom & Jerry |
Tom & Jerry | Tom & Jerry | Tom & Jerry | Tom & Jerry |
Зміна стосується лише другого рядка — подвійного екранування. Перший рядок у Google досі працює, але лише в Google. Останні два — правильні для всіх.
Як ми перевіряли
Три вибірки. Перша — 2 076 сторінок із першої десятки Google і джерел ШІ-відповідей за 48 комерційними запитами з нашого дослідження рекомендацій ШІ: це сайти, які реально отримують трафік за дорогими запитами. Друга — сайти наших клієнтів: головна і до чотирьох сторінок, що просуваються, з кожного, щоб великі сайти не переважили. Третя — 300 випадкових сторінок нашого власного сайту. Усі сторінки завантажені напряму, без платних сервісів.
На кожній сторінці ми дістали всі блоки JSON-LD і прогнали їх трьома способами: як Google читав раніше, як читає тепер і як вимагає стандарт. Підсумок рахуємо за сайтами, а не за сторінками: сторінки одного шаблону повторюють одну помилку, і рахунок за сторінками сильно її роздуває. Наприклад, майже половина сторінок із подвійним екрануванням у нашій вибірці припала на один сайт.
Кого зачепила зміна: 1,6% сайтів
Із 748 сайтів із розміткою подвійне екранування знайшлося у 12. Понад половина з них — видання однієї медіагрупи: у них спільний шаблон, у якому опис автора проходить екранування двічі. Тому в цих сайтів зараз у розмітці біографії автора стоїть буквальний «'» замість апострофа. Серед сайтів наших клієнтів таких два з 295.
Висновок простий: якщо ви не бачили в Search Console нових помилок структурованих даних після 21 серпня, майже напевно вас ця зміна не зачепила. Паніка в галузевих виданнях була непропорційною масштабу.
Проблема більша: Shopify і символи, які не розкодовує ніхто
Є другий спосіб зіпсувати символ, і Google до нього стосунку не має. Сутність виявляється схованою всередині JSON-екранування: у коді стоїть \u0026amp;. HTML-розкодування її не бачить — амперсанда в тексті немає, — а після розбору JSON у значенні залишається буквальний «&». Жоден обробник за стандартом це сміття не прибере.
Таке ми знайшли в 11 із 47 сайтів на Shopify в топі Google — це 23%. На всіх інших платформах — у 2,3%. Розрив удесятеро. Справа не в самій платформі, а в шаблонах тем: текст спершу екранують для HTML, а потім ще раз пакують у JSON фільтром, і сутність проходить наскрізь. Найчастіше страждає опис товару — він приходить із візуального редактора вже із сутностями всередині.
Найбільша проблема: третина сайтів пише розмітку «лише для Google»
У 36% сайтів із топу Google і в 23% сайтів наших клієнтів усередині JSON-LD є звичайні HTML-сутності: &, ", '. Google їх досі розуміє — одного проходу розкодування вистачає. Але це єдиний, хто так робить із власної волі. Стандарт вимагає читати їх буквально, тому будь-який інший споживач розмітки — інші пошуковики, валідатори, сервіси, що збирають дані про товари й компанії за специфікацією, — побачить у назві «Tom & Jerry».
Майже всі ці символи безпечно записувати в JSON як є: і амперсанд, і лапки-ялинки, і апостроф. Звичайні прямі лапки всередині рядка JSON екрануються зворотною косою рискою, а не HTML-сутністю. Єдине, чого всередині тегу script справді не можна, — послідовності, які браузер прийме за кінець скрипту. Для них, як і радить Google, є JSON-екранування: \u003C замість «<» і \u0026 замість «&».
Перевірили на собі — і знайшли
На нашому сайті розмітка є на всіх 300 перевірених сторінках, і подвійного екранування не знайшлося. Але дві сторінки потрапили в клас «лише для Google»: у хлібних крихтах назва англійської статті йшла в розмітку як «Web 2.0 & Cascade Promotion».
Причина — саме та, через яку сутності найчастіше й потрапляють у JSON-LD. Шаблон сторінки екранує заголовок для виведення в HTML, а код, що будує хлібні крихти, бере вже екранований рядок і кладе його в JSON. На екрані все виглядає правильно, у розмітці — ні. Ми виправили це 29 вересня одним рядком: перед пакуванням у JSON рядок розкодовується назад. Перевірили знову — сутностей у розмітці нуль.
Як перевірити й виправити свій сайт
Знайдіть сутності в розмітці
Відкрийте код сторінки, знайдіть блоки application/ld+json і пошукайте в них символ амперсанда. Будь-яка послідовність на кшталт &, ", ' або \u0026amp; усередині цих блоків — привід для правки. Перевірте хоча б по одній сторінці кожного шаблону: головну, товар, статтю, категорію.
\u0026.Знайдіть місце, де текст екранується двічі
Майже завжди причина одна: у JSON потрапляє рядок, уже підготовлений для виведення в HTML. Шукайте в коді, звідки беруться значення розмітки: заголовок, опис, ім'я автора. Якщо перед пакуванням у JSON до них застосовується екранування для HTML — це і є помилка.
// Погано: рядок уже екранований для HTML — сутності підуть у JSON-LD
$title = htmlspecialchars($post['title']);
echo json_encode(['headline' => $title]);

// Добре: у JSON — вихідний текст, а прапорці самі перетворять & і < на \u0026 і \u003C
echo json_encode(['headline' => $post['title']],
JSON_HEX_TAG | JSON_HEX_AMP | JSON_UNESCAPED_UNICODE);Якщо сайт на Shopify — перевірте тему
Шукайте в шаблоні розмітки фільтр екранування, застосований до фільтра json, і опис товару, що приходить із візуального редактора із сутностями всередині. Порядок фільтрів тут вирішує: екранувати для HTML треба те, що виводиться на сторінку, а в JSON — віддавати вихідний текст.
\u0026amp;, \u0026quot; і \u0026#39;.Перевірте результат інструментами Google
Проженіть сторінку через перевірку розширених результатів і через перевірку URL у Search Console. Дивіться не лише на «помилок немає», а на самі значення полів: назву, опис, ім'я автора. Саме там видно буквальне «&», яке валідатор помилкою не вважає.
Часті запитання
Що саме змінив Google у розборі JSON-LD 21 серпня 2026 року?
Раніше Google знімав HTML-екранування з розмітки двічі, тепер — один раз. Тому двічі екранований символ, наприклад амперсанд, записаний як сутність від сутності, тепер потрапляє в значення не як символ, а як текст сутності. Звичайні, одноразово екрановані сутності Google досі розуміє.
Як зрозуміти, чи зачепила зміна мій сайт?
Відкрийте код сторінки й пошукайте всередині блоків JSON-LD сутності, записані двічі: після амперсанда йде слово amp, а потім ще одна сутність. У нашій перевірці таке знайшлося лише в 1,6% сайтів із топу Google і в 0,7% сайтів клієнтів, причому понад половина випадків — один шаблон однієї медіагрупи.
Чи треба прибирати з розмітки HTML-сутності, якщо Google їх розуміє?
Так, якщо вам важливо, щоб розмітку правильно читали не лише в Google. Стандарт JSON-LD вимагає розуміти такі сутності буквально, і будь-який обробник, що дотримується специфікації, побачить у значенні текст сутності замість символу. У нашій перевірці так записана розмітка в 36% сайтів із топу Google.
Як правильно записати амперсанд і лапки в JSON-LD?
Найпростіше як є: усередині тегу script амперсанд, апостроф і типографські лапки безпечні. Прямі лапки всередині рядка екрануються зворотною косою рискою за правилами JSON. Якщо потрібен повний захист від випадкового закриття тегу script, використовуйте JSON-екранування: \u0026 для амперсанда і \u003C для знака «менше».
Чому на Shopify зіпсовані символи трапляються частіше?
Не через саму платформу, а через шаблони тем. Текст спершу екранується для виведення в HTML, а потім пакується в JSON, і сутність виявляється схованою всередині JSON-екранування. У нашій вибірці так у 23% сайтів на Shopify проти 2,3% на інших платформах.
Чи впливає помилка в JSON-LD на позиції?
Напряму — ні: розмітка відповідає за те, як сторінка може виглядати у видачі і наскільки точно машини розуміють її дані. Але зіпсоване значення потрапить у розширений сніпет, у картку товару або в чужу систему, що читає розмітку, саме в зіпсованому вигляді. Виправлення зазвичай займає один рядок коду.
Джерела: допис Google Search Central у LinkedIn (21 серпня 2026), специфікація JSON-LD 1.1 W3C, розділ 7.2, специфікація HTML (WHATWG) про сирі текстові елементи. Власні дані — 3 167 сторінок з 1 271 сайту, завантажених 29 вересня 2026 року: топ-10 Google за 48 комерційними запитами, сайти клієнтів PromoPilot (без назв) і 300 сторінок promopilot.link.