Google про robots.txt: шляхи не англійською кодуйте, а ШІ-краулери називайте на ім'я
21 жовтня 2026 Google Search Central випустив відео про те, що можна писати в robots.txt. Що там сказано про нелатинські шляхи, неправильні рядки та ШІ-краулери, і короткий чек-лист для вашого файлу.
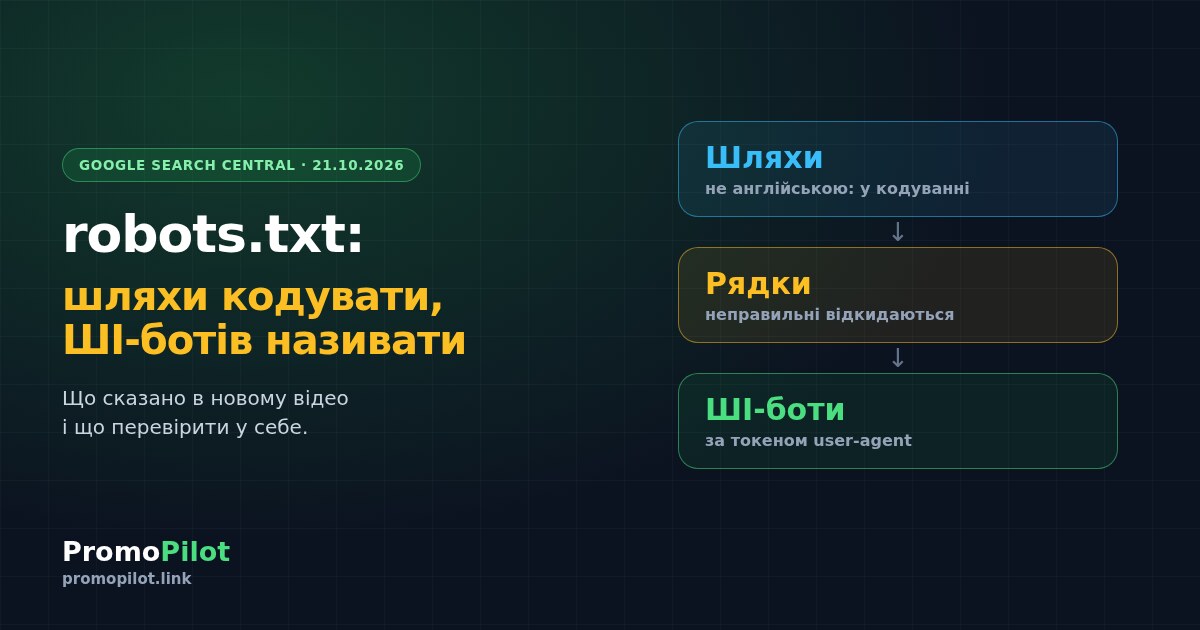
21 жовтня 2026 канал Google Search Central випустив другий епізод серії Non-Canonical Cabinet, «What can you actually put in a robots.txt?», з Ґері Іллісом і Черрі Проммавін. Нових правил Google не оголошував: це пояснення, що файл робить і чого не робить. Найбільше воно важливе сайтам з нелатинськими адресами і тим, хто пише правила для ШІ-краулерів. Нижче: що підтверджено і звідки це відомо, що це може означати для вашого сайту і що перевірити за один вечір.
Що сталося і звідки це відомо
Епізод опубліковано на YouTube-каналі Google Search Central. Дата, 21 жовтня, і зміст епізоду наведені за повідомленнями Search Engine Roundtable та Search Engine Journal (посилання наприкінці): самі ми відео не розшифровували. Там, де пункт підтверджує документація Google, ми це позначаємо.
- За повідомленнями, спікери назвали robots.txt протоколом побажань щодо доступу (RFC 9309): він визначає, які URL краулеру можна запитувати, але не те, що відбувається з даними після цього.
- За повідомленнями, рядок, якого парсер не розуміє, мовчки відкидається. Документація це підтверджує: Google підтримує чотири поля (user-agent, allow, disallow, sitemap), не підтримує crawl-delay і ігнорує неправильні рядки.
- За повідомленнями, щоб закрити конкретного ШІ-краулера, у правилі треба назвати його токен user-agent. Вигадані формулювання ігноруються.
- За повідомленнями, Черрі Проммавін радить писати шляхи не англійською у відсотковому кодуванні, бо парсер Google справляється із «сирими» символами, а інші краулери можуть не впоратися. Бік Google підтверджує документація: шляхи в правилах можуть бути в UTF-8 або у відсотковому кодуванні, Google порівнює їх у закодованому вигляді, а сам файл має бути в UTF-8.
Що це може означати для власника сайту
- Нелатинські адреси. Якщо у шляхах кирилиця, польські літери чи емодзі, правило в «сирому» вигляді в Google працює, судячи з документації, але інший краулер може зрозуміти його інакше. Безпечніше писати в закодованому вигляді. Це запобіжний захід, а не фактор ранжування.
- Помилки та вигадані директиви нічого не роблять. Невідомий парсеру рядок відкидається, і сторінка лишається доступною для обходу, наче рядка немає.
- Для ШІ-краулерів потрібні власні правила. Рядка «взагалі» мало: правило має називати токен потрібного краулера. І robots.txt лише просить сумлінних ботів не заходити. Це не захист закритого контенту.
- Жодних обіцянок щодо позицій тут немає. Епізод про те, як читається файл, а не про те, як ранжуються сторінки.
Що перевірити зараз
Відкрийте файл і прочитайте правила
Проженіть домен через перевірку robots.txt: вона показує правила Allow і Disallow, user-agent, рядки Sitemap та попередження на кшталт повністю закритого сайту. Перевірки одного URL у ній немає, для конкретної адреси використовуйте звіт про robots.txt у Search Console.
Знайдіть шляхи з нелатинськими символами
Звірте рядки Disallow і Allow з реальними адресами сайту. Якщо шлях з кирилицею, діакритикою чи емодзі записано «сирим», подумайте про запис у відсотковому кодуванні. Чисту версію можна зібрати в генераторі robots.txt.
Випишіть правила для ШІ-краулерів
Складіть список, яких краулерів ви хочете закрити чи дозволити, і перевірте, що в кожному правилі названо потрібний токен user-agent. У тому самому генераторі є пресети для ШІ-краулерів.
Перевірте, що файл і ключові сторінки відповідають
Відкрийте адресу файлу та кілька ключових сторінок у перевірці HTTP-статусу. Файл має відповідати 200, а сторінки, які ви хочете бачити в пошуку, не мають бути закриті випадково. Потім перевірте карту сайту з файлу в аналізаторі sitemap.
Подивіться, які сторінки дають покази
Перш ніж щось закривати, подивіться, які сторінки вже отримують покази. SEO Радар їх показує, тож корисну сторінку ви не закриєте помилково.
Чого ми поки не знаємо
- Які краулери, крім Google, справді неправильно читають «сирі» шляхи. У повідомленнях сказано «можуть», переліку немає.
- Чи зміниться документація Google. У документації, яку ми прочитали, допустимі і UTF-8, і відсоткове кодування.
- Впливу на позиції. Ні в повідомленнях, ні в документації про нього не сказано.
- Точних формулювань із відео: ми спираємося на два повідомлення і документацію, а не на розшифровку.
Джерела: Google Search Central, відео «What can you actually put in a robots.txt?»; Google Search Central, документація з robots.txt; Search Engine Roundtable, 21 жовтня 2026; Search Engine Journal, 22 жовтня 2026. Матеріал підготувала команда PromoPilot.