
Генератор robots.txt
Безкоштовний генератор robots.txt: оберіть пресет CMS (WordPress, WooCommerce, 1С-Бітрікс, Laravel, Next.js, примітка для Shopify), допишіть свої Allow/Disallow, вирішіть, що робити з AI-ботами — закрити навчання (GPTBot, ClaudeBot, Google-Extended…) і залишити ШІ-пошук або закрити всіх, — і додайте Sitemap. Файл перевіряється на типові помилки й збирається просто в браузері, без реєстрації.
Налаштування
Позначені боти отримають «Disallow: /». robots.txt — прохання, а не замок: сумлінні боти його дотримуються, інших зупиняє лише сервер або CDN (наприклад, блокування AI-ботів у Cloudflare).
robots.txt
Завантажте файл у корінь сайту (https://ваш-сайт/robots.txt) і перевірте живий файл у перевірці robots.txt. Доступ AI-ботів покаже AI Visibility Checker, а короткий опис сайту для ШІ збере генератор llms.txt.
Коротко про інструмент
robots.txt — текстовий файл у корені сайту, у якому ви просите роботів не заходити до деяких розділів. Виберіть пресет (WordPress, WooCommerce, Бітрікс, Next.js тощо), додайте свої шляхи, Sitemap і за бажанням закрийте AI-ботів, потім скопіюйте результат. Це прохання, а не захист: сумлінні боти його дотримуються, решта ні, а закрита сторінка все одно може потрапити в індекс.
- Ціна
- Безкоштовно
- Реєстрація
- Не потрібна
- Де відбувається обробка
- У вашому браузері — дані не надсилаються на сервер
- Що приймає
- Пресет сайту, шляхи Disallow і Allow (по одному на рядок), адреса Sitemap, прапорці Crawl-delay і список AI-ботів
- Ліміти
- Без реєстрації та без лімітів; лише генерація й перевірка тексту, файл на сайт потрібно викласти самостійно
- Результат
- Готовий текст robots.txt із кнопкою «Копіювати» чи «Завантажити» та список попереджень (конфлікт Allow і Disallow, закриття всього сайту, Crawl-delay)
- Оновлено
Відеоогляд 0:56 англійською, субтитри українською

Генератор robots.txt безкоштовно: пресети CMS + блокування AI-ботів (GPTBot, ClaudeBot)
Створіть robots.txt безкоштовно: пресети CMS (WordPress, WooCommerce, Shopify…), власні правила, рядок Sitemap і готові пресети для AI-краулерів.
Зміст відео
Текст відео
Write a robots.txt file, and decide what to do about AI crawlers. Here's a free generator that does both. Pick a site preset: WordPress, WooCommerce, Shopify and others. I'll choose WordPress, and the rules for its admin area and search pages appear on the right. Then the AI crawlers section. The preset, Block AI training, allow AI search, disallows the training bots like GPTBot and ClaudeBot, but leaves the search bots alone. Add a sitemap line, and download the file. Robots.txt is a request, not access control. It blocks crawling, not indexing. Blocking Google-Extended doesn't hurt your Google rankings. Free, no sign-up. The link is in the description. Subscribe for more free tools.
Як це виглядає
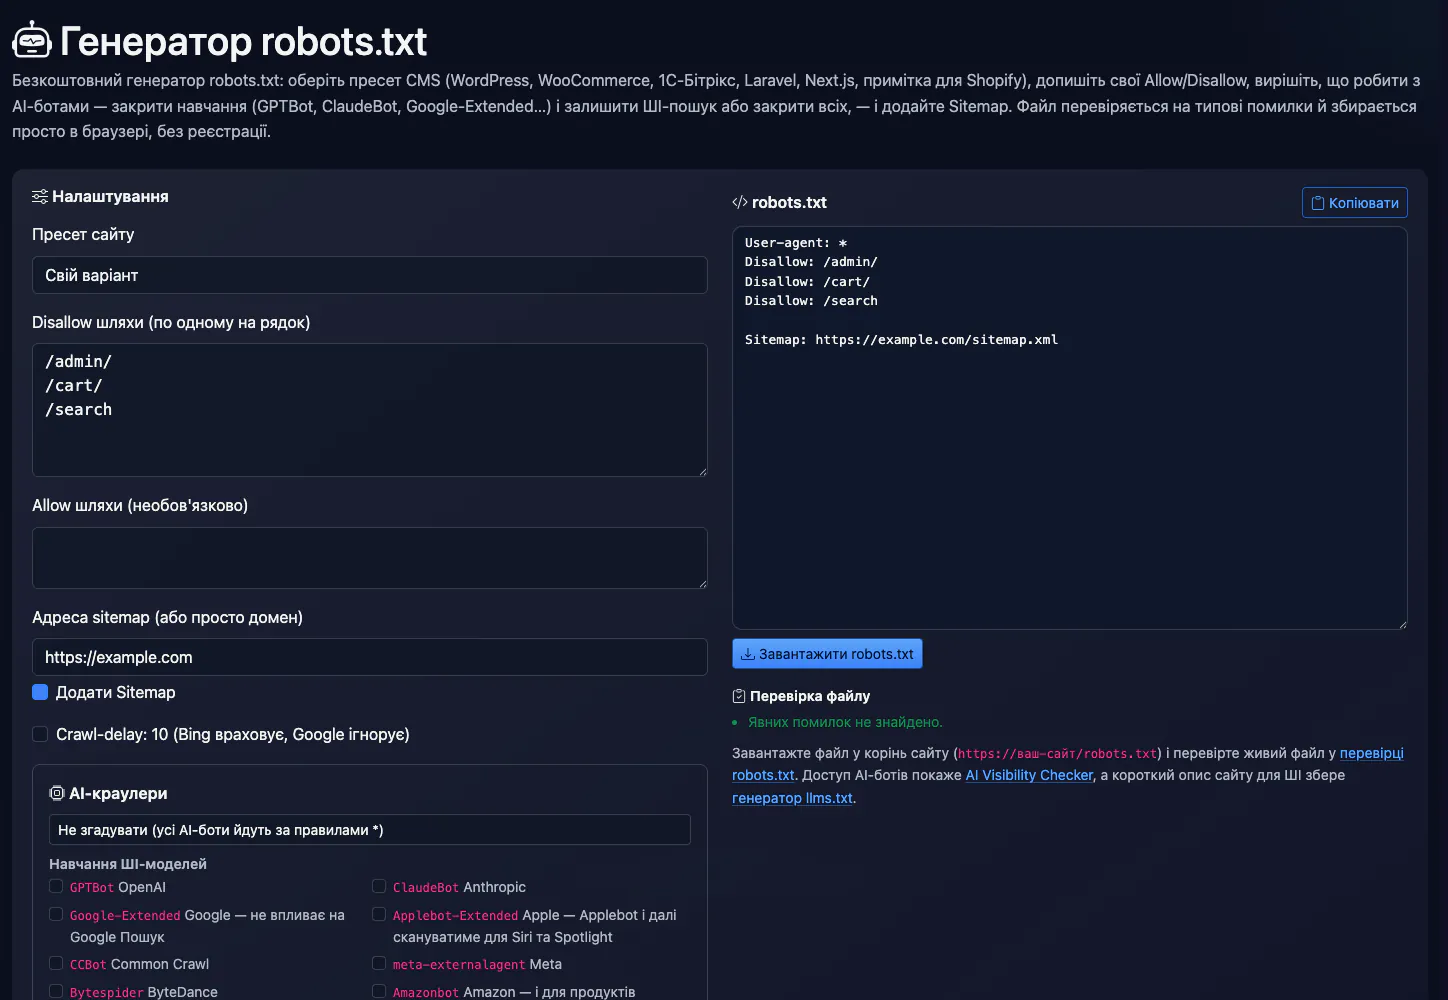
Генератор robots.txt онлайн
Генератор robots.txt збирає файл правил для пошукових і AI-ботів: пресети для WordPress, WooCommerce, 1С-Бітрікс, Laravel і Next.js, примітка для Shopify, свої шляхи Allow/Disallow, рядок Sitemap і окремий блок для AI-краулерів. Ботів навчання (GPTBot, ClaudeBot, Google-Extended тощо) можна закрити, не чіпаючи ботів ШІ-пошуку, які наводять посилання на ваш сайт. Результат одразу перевіряється на типові помилки.
Як користуватися
- Оберіть пресет своєї CMS або «Свій варіант» і виправте шляхи Allow та Disallow
- Вирішіть, що робити з AI-ботами: не згадувати, закрити навчання чи закрити всіх
- Вкажіть адресу sitemap і перегляньте попередження під файлом
- Завантажте robots.txt, покладіть у корінь сайту й перевірте живий файл
FAQ
Для кого й сценарії
- Сайт на WordPress чи Бітрікс. Виберіть пресет із типовими службовими шляхами й додайте адресу Sitemap.
- Закрити пошук, фільтри та кошик. Впишіть свої шляхи з шаблонами
*і$, наприклад/*?sort=. - Рішення щодо ШІ-ботів. Закрийте лише навчання моделей або й ШІ-пошук, вирішивши, чи потрібна вам видимість у відповідях ШІ.
Чесні обмеження
- robots.txt — прохання, а не замок. Несумлінні боти його ігнорують; OpenAI і Perplexity самі пишуть, що для запитів на прохання користувача файл може не застосовуватися.
- Закрита сторінка може лишитися в індексі. Щоб прибрати її з видачі, потрібен noindex, а не Disallow.
- Crawl-delay Google ігнорує. Його враховує Bing; Google керує частотою інакше.
- Shopify. Платформа генерує robots.txt сама, тож правила змінюють через шаблон robots.txt.liquid, а не завантаженням файлу.
- Файл треба викласти в корінь хоста. Для кожного піддомену й протоколу потрібен свій файл; генератор не публікує й не перевіряє сайт.
Далі за темою: перевірка robots.txt, генератор sitemap, видимість у ШІ, llms.txt.
PromoPilot та аналоги: порівняння
Порівнюємо лише те, що підтверджено на офіційних сторінках сервісів. Якщо підтвердити не вдалося, у комірці стоїть «—».
| Параметр | PromoPilot | Google Search Central: спецификация robots.txt |
|---|---|---|
| Пресети CMS | ✓ WordPress, WooCommerce, Бітрікс, Laravel, Next.js | ✗ |
| Список AI-ботів | ✓ 14 ботів | ✗ |
| Перевірка конфліктів правил | ✓ | Правило: перемагає найконкретніше, за конфлікту — менш суворе |
| Робота в браузері | ✓ | — |
Таблицю можна прокрутити вбік
Де ми слабші: ми не перевіряємо опублікований файл і конкретні URL, немає пресету для Joomla, Drupal та інших CMS, а список AI-ботів треба періодично звіряти з їхніми офіційними сторінками.
Коли обрати PromoPilot: Коли треба швидко зібрати коректний robots.txt за пресетом CMS і перевірити його на типові помилки. Для перевірки вже опублікованого файлу й тестування URL використовуйте перевірку robots.txt або Search Console.
Перевірено: . «—» — не підтверджено на офіційній сторінці; умови та ціни сервісів змінюються, уточнюйте на їхніх сайтах.
Як влаштований robots.txt
robots.txt — текстовий файл у корені сайту (https://example.com/robots.txt). Він складається з груп: рядок User-agent називає бота, під ним ідуть правила Allow і Disallow зі шляхами. Головне, що треба пам’ятати під час складання файлу:
- Бот обирає одну групу — найточнішу для свого імені. Якщо для GPTBot є своя група, правил для
*він уже не читає. Тому генератор не пише окрему групу зAllow: /для «дозволених» AI-ботів: інакше їм відкрилися б і/wp-admin/, і все, що ви закрили для інших. - Перемагає найдовший збіг.
Allow: /wp-admin/admin-ajax.phpсильніше заDisallow: /wp-admin/. За рівної довжини Google обирає Allow. - Працюють
*і$.Disallow: /*?sort=закриває будь-які адреси з параметром сортування,Disallow: /*.pdf$— усі PDF. - Рядок
Sitemapне належить до груп і пишеться повною адресою. - Google не підтримує
Crawl-delay; Bing його враховує. Ліміт розміру файлу для Google — 500 КіБ.
AI-краулери: кого закривати і чим це загрожує
AI-боти діляться на три групи, і рішення щодо кожної — різне.
| Група | Боти | Якщо закрити |
|---|---|---|
| Навчання моделей | GPTBot (OpenAI), ClaudeBot (Anthropic), CCBot (Common Crawl), meta-externalagent (Meta), Bytespider (ByteDance), Amazonbot (Amazon), а також токени Google-Extended і Applebot-Extended | Контент не піде в майбутні набори даних для навчання. На Google Пошук і Bing це не впливає. |
| ШІ-пошук | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Сайт перестане з’являтися з посиланням у відповідях ChatGPT Search, Claude і Perplexity — це вже втрата трафіку. |
| Запити користувачів | ChatGPT-User, Claude-User, Perplexity-User | Асистент не зможе відкрити сторінку, коли користувач сам дав посилання чи попросив знайти відповідь. OpenAI і Perplexity попереджають, що ці запити можуть не підкорятися robots.txt. |
Особливі випадки. Google-Extended — не окремий бот, а токен: сканує сайт звичайний Googlebot, а заборона означає «не використовувати контент для навчання й відповідей Gemini». За документацією Google, на потрапляння в Пошук і ранжування він не впливає. Applebot-Extended працює так само: заборона прибирає контент з навчання моделей Apple, але Applebot і далі скануватиме сайт для Siri, Spotlight і Safari. Amazonbot Amazon описує як бота для покращення своїх сервісів, дані якого можуть використовуватися для навчання моделей, — тому він у групі навчання.
Найчастіший вибір — пресет «Закрити навчання ШІ, залишити ШІ-пошук»: контент не йде в навчання, а посилання з ШІ-відповідей і далі приводять відвідувачів. Вийде такий блок:
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: meta-externalagent
User-agent: Bytespider
User-agent: Amazonbot
Disallow: /
Після публікації перевірте, як бачать сайт різні AI-боти, в AI Visibility Checker, а якщо хочете, щоб ШІ краще розумів сайт, додайте файл llms.txt.
robots.txt — прохання, а не замок
Файл дотримуються сумлінні боти; ніщо технічно не заважає іншим його ігнорувати. Якщо ботів треба зупинити по-справжньому, це робиться на сервері або в CDN. У Cloudflare, наприклад, є керований robots.txt із правилами для AI-краулерів (доступний на всіх тарифах) і окреме блокування ботів на рівні мережі. І не використовуйте robots.txt, щоб сховати секретні адреси: файл публічний, і рядок Disallow: /secret-admin/ лише підкаже, де шукати.
Пресети CMS: що в них і чому
- WordPress: закриті
/wp-admin/(крімadmin-ajax.php), внутрішній пошук/?s=і/search/, посилання?replytocom=./wp-includes/і/wp-content/plugins/не закриваємо: там CSS і JS, без яких Google не відмалює сторінку. Файл у корені замінює віртуальний robots.txt WordPress; у Yoast SEO його можна правити в «Інструменти → Редактор файлів». - WooCommerce: до правил WordPress додано кошик, оформлення замовлення, особистий кабінет і посилання
?add-to-cart=. - 1С-Бітрікс: закрита службова тека
/bitrix/, але відкриті/bitrix/templates/,/bitrix/js/,/bitrix/cache/,/bitrix/components/,/bitrix/panel/і/upload/, інакше Google не побачить оформлення й картинок. - Shopify: файл генерує сама платформа, завантажити свій не можна. Правила змінюють у шаблоні
robots.txt.liquid(Інтернет-магазин → Теми → Редагувати код → Додати шаблон → robots); генератор підготує додаткові рядки. - Laravel: веб-корінь —
/public, тож/vendorчи.envззовні недоступні й у robots.txt їх не перелічуємо. Закриті сторінки входу, реєстрації та скидання пароля. - Next.js: закрито лише
/api/. Теку/_next/не чіпайте — у ній JS і CSS сторінок.
Типові помилки, які ловить перевірка
- Шлях без початкового
/(Disallow: admin) — таке правило не спрацює. - Закриті CSS і JS або теки з ними — Google не зможе відмалювати сторінку й оцінити її як користувач.
Disallow: /для всіх ботів — так закривають тестові копії; на робочому сайті це обнуляє пошуковий трафік.- Дублі й однаковий шлях в Allow і Disallow, пробіли й кирилиця в шляхах без кодування.
- Sitemap відносною адресою або без рядка Sitemap взагалі. Карту сайту збере генератор sitemap.
Запам’ятайте: robots.txt забороняє сканування, а не індексацію. Щоб прибрати сторінку з пошуку, її треба залишити відкритою й поставити noindex. Готовий файл на сайті перевіряйте перевіркою robots.txt — вона покаже, як правила застосовуються до конкретної адреси.
Покращте позиції в пошуку
SEO-проблеми можуть коштувати вам трафіку. Каскадний лінкбілдінг покращить видимість сайту в пошуку.