Ile witryn blokuje boty AI w robots.txt, 5 071 witryn
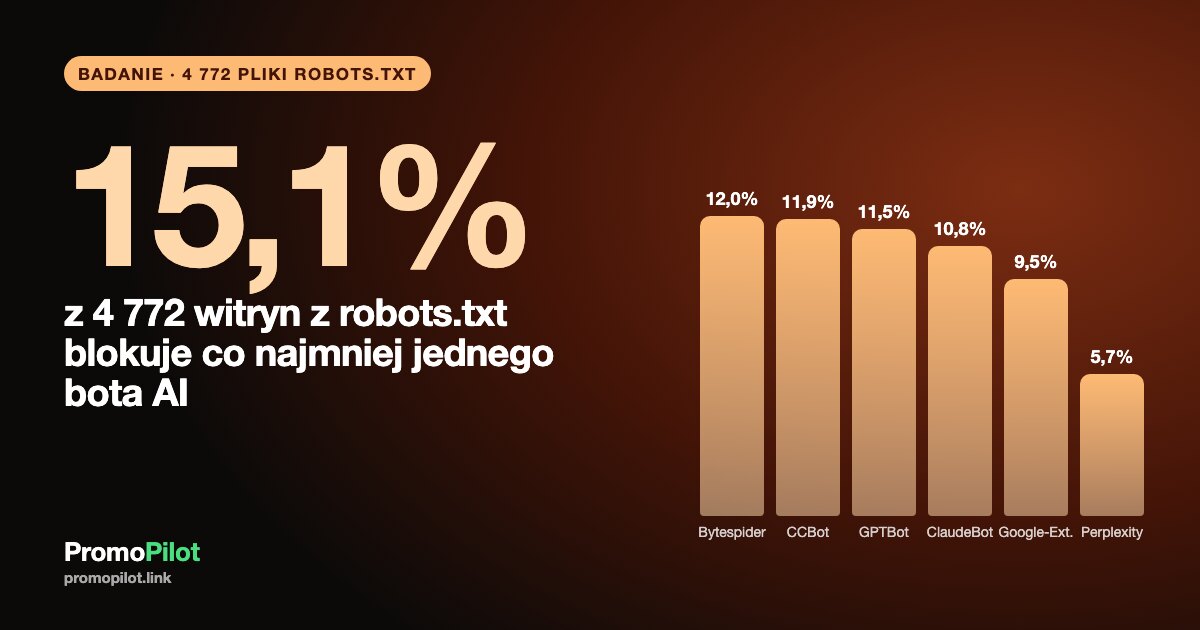
15–16 listopada 2026 roku odczytaliśmy plik robots.txt u 4 772 witryn: 15,1% z nich (719) regułą Disallow: / zamyka całą witrynę przed co najmniej jednym robotem AI. Najczęściej blokowany jest Bytespider od ByteDance (12,0%), potem CCBot od Common Crawl (11,9%) i GPTBot od OpenAI (11,5%); boty,…
15–16 listopada 2026 roku odczytaliśmy plik robots.txt u 4 772 witryn: 15,1% z nich (719) regułą Disallow: / zamyka całą witrynę przed co najmniej jednym robotem AI. Najczęściej blokowany jest Bytespider od ByteDance (12,0%), potem CCBot od Common Crawl (11,9%) i GPTBot od OpenAI (11,5%); boty, które pobierają strony do odpowiedzi na żywo i wyszukiwania AI, są blokowane wyraźnie rzadziej (OAI-SearchBot 3,6%). Osobno: prawdziwy plik llms.txt ma 22,5% z 5 071 witryn, a witryny blokujące boty AI mają go rzadziej (15,6% wobec 25,1%). Dalej: ranking botów, omówienie tego, czym są te boty oraz co daje i czego nie daje ich blokada, obraz llms.txt, tabela decyzji dla Twojej witryny i metodologia. Zastrzeżenie: próba nie jest losowa (witryny z naszej pamięci podręcznej wyników wyszukiwania), więc liczby opisują tę próbę, a nie cały internet.
Dane: skanowanie PromoPilot, 6 000 witryn, 15–16 listopada 2026 (sprawdzenie llms.txt 16 listopada); wyłączono 661 witryn za WAF, 178 niedostępnych i 90 z innymi błędami, w obliczeniach 5 071, robots.txt znaleziono u 4 772
Kluczowe liczby
- 15,1% witryn (719 z 4 772 z plikiem robots.txt) blokuje co najmniej jednego z 10 śledzonych botów AI. U 121 z nich (2,5% wszystkich witryn) jest też ogólne
Disallow: /dla wszystkich robotów, więc udział skierowany właśnie przeciw botom AI to 598 witryn, 12,5%. - Ranking według botów: Bytespider 12,0%, CCBot 11,9%, GPTBot 11,5%, ClaudeBot 10,8%, Google-Extended 9,5%, anthropic-ai 8,8%, Applebot-Extended 8,2%, PerplexityBot 5,7%, ChatGPT-User 5,3%, OAI-SearchBot 3,6%.
- Blokada to zwykle „wszystko albo nic”: spośród 719 witryn blokujących 379 (52,7%) blokuje 7 lub więcej z 10 botów, 95 (13,2%) blokuje wszystkie 10, a 100 (13,9%) dokładnie jednego.
- Trenowanie a odpowiedzi na żywo: 15,0% witryn blokuje co najmniej jednego bota do trenowania, 6,6% co najmniej jednego bota wyszukiwania lub odpowiedzi, a 8,4% blokuje wyłącznie boty do trenowania. Spośród 549 witryn blokujących GPTBot 382 (69,6%) zostawia OAI-SearchBot otwartego.
- Content-Signal (dyrektywa robots.txt dla preferencji search, ai-input i ai-train) występuje na 5,4% witryn (258); 90 z nich używa jej, nie blokując żadnego bota.
- llms.txt: prawdziwy plik ma 22,5% z 5 071 witryn (1 139), llms-full.txt 5,1% (259); 8,6% (435) odpowiada kodem 200 z zaślepką HTML lub przekierowaniem, tych nie liczymy; 63,5% zwraca 404.
- Witryny blokujące boty AI rzadziej udostępniają llms.txt: 15,6% (112 z 719) wobec 25,1% (1 019 z 4 053 bez blokady), wśród witryn z plikiem robots.txt.
- Według CMS (metatag generator): bez metatagu generator co najmniej jednego bota AI blokuje 17,6% witryn, WordPress 9,3% (462 witryny), Drupal 19,1% (47), inne CMS i kreatory 5,3% (587).
Ranking: ile witryn blokuje każdego bota AI
Dla każdej witryny przeanalizowaliśmy robots.txt i zapisaliśmy, którym z 10 user-agentów AI zabroniono dostępu do całej witryny. Podstawą jest 4 772 witryn, na których znaleziono robots.txt (94,1% z 5 071, które udało się odczytać). Ranking poniżej.

| # | Bot | Witryn blokuje | Odsetek z 4 772 |
|---|---|---|---|
| 1 | Bytespider | 571 | 12,0% |
| 2 | CCBot | 569 | 11,9% |
| 3 | GPTBot | 549 | 11,5% |
| 4 | ClaudeBot | 515 | 10,8% |
| 5 | Google-Extended | 452 | 9,5% |
| 6 | anthropic-ai | 421 | 8,8% |
| 7 | Applebot-Extended | 391 | 8,2% |
| 8 | PerplexityBot | 271 | 5,7% |
| 9 | ChatGPT-User | 254 | 5,3% |
| 10 | OAI-SearchBot | 173 | 3,6% |
Widać dwie prawidłowości. Pierwsza: pierwsze siedem pozycji zajmują boty zbierające dane do trenowania modeli lub tokeny związane z trenowaniem, a trzy ostatnie są związane z wyszukiwaniem i odpowiedziami. Właściciele znacznie chętniej blokują „bota, który uczy się na moich treściach”, niż „bota, który może przysłać mi odwiedzającego”. Druga: przestarzały token anthropic-ai (8,8%) jest blokowany niemal tak samo często jak ClaudeBot (10,8%): oba zablokowało 384 witryny, co najmniej jeden z dwóch 552 (11,6% wszystkich), co wskazuje, że wiele plików robots.txt kopiuje się z gotowych list, zamiast pisać osobno dla każdego bota.
Dla większości witryn blokada to „wszystko albo nic”
719 witryn blokujących nie wybiera bot po bocie. Połowa z nich (379) blokuje siedem lub więcej botów, 95 blokuje wszystkie dziesięć, a tylko 100 blokuje jednego.

Jedno wyjaśnienie dotyczące samej liczby. Nasz parser uznaje bota za zablokowanego, gdy jego reguła zabrania dostępu do całej witryny. U 121 z 719 witryn jest też ogólne Disallow: / dla wszystkich robotów, które zamyka witrynę także przed wyszukiwarkami (2,5% wszystkich witryn z robots.txt; część to witryny w budowie). Jeśli potrzebny jest udział dotyczący wyłącznie botów AI, trzeba je odjąć: 598 witryn, 12,5%.
Anatomia: czym jest każdy bot oraz co daje i czego nie daje jego blokada
„Zablokowanie AI” to nie jedna decyzja. Dziesięć user-agentów wykonuje trzy różne zadania: zbiera strony do trenowania modeli, buduje indeks wyszukiwania, który odpowiada na pytania z cytatami, i pobiera stronę właśnie teraz, bo człowiek poprosił o to asystenta. Skutki blokady są w każdym przypadku inne. Opisy opierają się na publicznej dokumentacji dostawców w takiej postaci, w jakiej czytaliśmy ją w listopadzie 2026 roku; dokumentacja robotów się zmienia, więc zanim oprzesz się na jakimś szczególe, sprawdź strony pod linkami.
| Bot | Czyj | Zadanie | Co daje blokada | Czego nie daje |
|---|---|---|---|---|
| GPTBot | OpenAI | Robot do trenowania | Prosi OpenAI, by nie używało Twoich stron do trenowania przyszłych modeli | Nie usuwa Cię z wyszukiwania ChatGPT, które korzysta z OAI-SearchBot |
| OAI-SearchBot | OpenAI | Indeks wyszukiwania dla wyników ChatGPT | Prosi OpenAI, by nie uwzględniało Twoich stron w funkcjach wyszukiwania | To nie robot do trenowania; jego blokada nie zatrzyma trenowania |
| ChatGPT-User | OpenAI | Pobiera stronę, gdy prosi o to użytkownik lub własny GPT | Prosi OpenAI, by nie otwierało Twoich stron na żądanie użytkowników | OpenAI zaznacza, że reguły robots.txt mogą nie obowiązywać przy tych odwiedzinach z inicjatywy użytkownika |
| ClaudeBot | Anthropic | Robot do trenowania | Prosi Anthropic, by nie zbierało Twoich stron do trenowania | Nie obejmuje Claude-User (żądania użytkowników) ani Claude-SearchBot (wyszukiwanie): Anthropic wymienia je osobno |
| anthropic-ai | Anthropic | Starszy token do trenowania | Stary token. W aktualnej dokumentacji Anthropic wymienione są ClaudeBot, Claude-User i Claude-SearchBot; pozostawienie anthropic-ai na liście nie szkodzi | Wiele witryn wpisuje go z przyzwyczajenia |
| Google-Extended | Token robots.txt, a nie osobny robot; steruje użyciem treści do trenowania i groundingu Gemini | Wyłącza Twoje treści z tych zastosowań Gemini | Nie zmienia skanowania ani indeksowania w Google Search; Google zaznacza, że token nie steruje funkcjami Wyszukiwarki, takimi jak AI Overviews | |
| Applebot-Extended | Apple | Token; steruje tym, czy treści zebrane przez Applebot służą do trenowania modeli Apple | Wyłącza Twoje treści z tego trenowania | Sam Applebot nadal skanuje na potrzeby wyszukiwania Siri i Spotlight |
| PerplexityBot | Perplexity | Indeksuje strony dla wyszukiwania Perplexity | Prosi Perplexity, by nie pokazywało Twoich stron w wynikach | Perplexity twierdzi, że nie służy do trenowania modeli bazowych; odwiedziny z inicjatywy użytkownika obsługuje inny agent |
| CCBot | Common Crawl | Buduje otwarte archiwum sieci, z którego korzysta wielu twórców AI do trenowania | Nie wpuszcza nowych stron do przyszłych zbiorów Common Crawl | Nie usuwa tego, co wcześniejsze skany już zapisały |
| Bytespider | ByteDance | Robot dla produktów i modeli ByteDance | Prosi ByteDance, by nie skanowało witryny | Niektórzy administratorzy zgłaszają, że ignoruje robots.txt; jeśli to ważne, blokuj też na poziomie serwera lub CDN |
Cztery rzeczy, których robots.txt nie potrafi
- To prośba, a nie zamek. Poprawnie działający robot go czyta, niepoprawny nie. Aby blokada działała, użyj reguł CDN, zapory sieciowej lub serwera WWW (to silniejsze narzędzie stosuje 661 witryn, które odpowiedziały naszemu robotowi stroną blokady WAF).
- Nie działa wstecz. Wpływa na przyszłe skanowanie. Treści, które robot już zebrał lub które leżą w starszym archiwum Common Crawl, pozostają tam, gdzie były.
- Trenowanie i odpowiedzi to osobne przełączniki. Zablokowanie botów do trenowania (GPTBot, ClaudeBot, Google-Extended) to inna decyzja niż zablokowanie botów, od których zależy, czy Twoją stronę można zacytować w odpowiedzi AI (OAI-SearchBot, PerplexityBot). W naszych danych 8,4% witryn blokuje wyłącznie boty do trenowania, 6,6% blokuje obie grupy, a same boty wyszukiwania blokują tylko 4 witryny.
- Nie ukrywa strony przed Google Search. Google-Extended jest oddzielony od Googlebota. Zablokowanie pierwszego nie rusza zwykłego skanowania wyszukiwarki, natomiast ogólne
Disallow: /lub blokada Googlebota zamykają witrynę przed wyszukiwaniem.
Gdzie witryny się rozchodzą: trenowanie czy wyszukiwanie odpowiedzi
Weźmy OpenAI. Spośród 549 witryn blokujących GPTBot 249 (45,4%) blokuje też ChatGPT-User, a 167 (30,4%) także OAI-SearchBot; 382 (69,6%) blokuje robota do trenowania, ale zostawia otwartego robota wyszukiwania. To spójna polityka: zrezygnować z trenowania i pozostać w zasięgu wyszukiwania ChatGPT. Para Google zachowuje się podobnie: 121 witryn blokuje GPTBot bez Google-Extended, a 24 blokują Google-Extended bez GPTBot.
Nowsza dyrektywa Content-Signal wyraża ten sam podział w jednym wierszu, z osobnymi wartościami yes lub no dla search, ai-input i ai-train. Występuje na 5,4% witryn (258). Spośród nich 168 (65,1%) blokuje też co najmniej jednego bota AI po nazwie, a 90 używa samego sygnału. Odnotowujemy tylko istnienie dyrektywy; czy dany robot jej przestrzega, zależy od robota.
llms.txt: ile witryn ma prawdziwy plik
llms.txt to propozycja z 2024 roku: plik Markdown pod adresem /llms.txt, który wymienia dla modeli językowych najprzydatniejsze strony witryny z krótkimi opisami; llms-full.txt to dłuższy wariant z treścią wstawioną w plik. To nie jest oficjalny standard i w chwili pisania nie znamy dużego dostawcy AI, który potwierdziłby użycie tych plików do wyszukiwania lub rankingu, więc traktuj go jako tanią dokumentację dla maszyn, a nie dźwignię widoczności. Sprawdziliśmy go mimo to, bo to druga połowa pytania „co powiedzieć AI”.
„Prawdziwym plikiem” nazywamy tylko adres, który odpowiada 200, nie jest stroną HTML i nie przekierowuje na inną stronę. To wyklucza 435 witryn (8,6%), które odpowiadają 200 ze stroną HTML (soft 404 lub zaślepka) albo przekierowaniem.

| Miara | Witryn | Odsetek |
|---|---|---|
| Prawdziwy plik llms.txt | 1 139 | 22,5% z 5 071 |
| Prawdziwy plik llms-full.txt (wszystkie mają też llms.txt) | 259 | 5,1% z 5 071 |
| 200 z zaślepką HTML lub przekierowaniem (nie liczymy) | 435 | 8,6% z 5 071 |
| 404 | 3 218 | 63,5% z 5 071 |
| Prawdziwy llms.txt wśród witryn blokujących boty AI | 112 z 719 | 15,6% |
| Prawdziwy llms.txt wśród witryn bez blokady (robots.txt znaleziono) | 1 019 z 4 053 | 25,1% |
Jak wyglądają prawdziwe pliki: mediana to 5 922 bajty, 90. percentyl 56 975 bajtów; 77,9% zaczyna się od nagłówka (H1), jak sugeruje format; 89,0% zawiera co najmniej jeden link Markdown (mediana pliku to 24 linki); 10,3% nie ma ich wcale i jest w praktyce zwykłym tekstem. 11,6% jest serwowane jako text/markdown, reszta jako text/plain.
Związek z blokowaniem to tylko korelacja: witryny blokujące boty AI rzadziej publikują plik napisany dla systemów AI (15,6% wobec 25,1%), co pasuje do prostego odczytania, że te witryny świadomie nie angażują się w AI, a pozostałe tak. Nie możemy twierdzić, że jedno powoduje drugie; część plików tworzą automatycznie wtyczki i kreatory (udział wśród witryn na innych CMS i kreatorach to 35,3%, na WordPressie 25,5%, bez metatagu generator 20,6%). Nasza próba jest też przesunięta ku witrynom, które pojawiają się w wynikach wyszukiwania.
Według CMS i języka
CMS ustalamy po metatagu generator; 3 598 z 4 772 witryn go nie publikuje i jest to największa oraz najczęściej blokująca grupa. Grup poniżej 30 witryn nie pokazujemy. Uwaga: nazwy hostów w naszych danych są zahaszowane, więc podział według strefy domenowej (TLD) jest niemożliwy; jako najbliższy sygnał geograficzny pokazujemy język strony zadeklarowany w HTML.

| CMS (metatag generator) | Witryn z robots.txt | Blokuje dowolnego bota AI | Blokuje GPTBot | Plik llms.txt (z wszystkich witryn grupy) |
|---|---|---|---|---|
| Bez metatagu generator | 3 598 | 17,6% (632) | 13,4% | 20,6% (793 z 3 856) |
| Inny CMS lub kreator | 587 | 5,3% (31) | 4,6% | 35,3% (218 z 618) |
| WordPress | 462 | 9,3% (43) | 7,1% | 25,5% (120 z 471) |
| Drupal | 47 | 19,1% (9) | 8,5% | 10,6% (5 z 47) |
| MediaWiki | 42 | 4,8% (2) | 2,4% | 2,4% (1 z 42) |
| Joomla | 36 | 5,6% (2) | 2,8% | 5,4% (2 z 37) |
Podział według CMS czytaj ostrożnie. Witryny bez metatagu generator to często rozwiązania szyte na miarę, sklepy i większe witryny komercyjne, a ich właściciele najczęściej mają jakąś politykę; witryny na gotowych platformach zwykle zostawiają domyślny robots.txt platformy. Różnica dotyczy tego, kto prowadzi witrynę, nie mniej niż tego, jakiego oprogramowania używa. Grupy Drupal i MediaWiki są małe (47 i 42 witryny).
| Język HTML | Witryn z robots.txt | Blokuje dowolnego bota AI | Blokuje GPTBot |
|---|---|---|---|
| en | 1 655 | 12,6% (208) | 8,6% |
| ru | 823 | 7,2% (59) | 4,5% |
| uk | 516 | 10,1% (52) | 5,6% |
| brak zadeklarowanego języka | 505 | 34,7% (175) | 32,7% |
| sv | 336 | 13,7% (46) | 11,3% |
| de | 311 | 19,6% (61) | 17,4% |
| pl | 102 | 16,7% (17) | 9,8% |
| he | 89 | 11,2% (10) | 5,6% |
| es | 85 | 22,4% (19) | 20,0% |
| fr | 72 | 13,9% (10) | 11,1% |
| nl | 35 | 14,3% (5) | 2,9% |
Witryny niemieckojęzyczne i hiszpańskojęzyczne w tej próbie blokują częściej niż angielskojęzyczne, rosyjskojęzyczne i ukraińskojęzyczne. Grupa bez zadeklarowanego języka wyróżnia się wynikiem 34,7%, ponad dwukrotnie wyższym od średniej w próbie; dlaczego tak jest, nie analizowaliśmy. Traktuj tabelę języków jako opis tej próby, a nie statystykę krajową: próba pochodzi z zapytań wyszukiwania, które śledzimy.
Jak zdecydować dla swojej witryny
Nie ma ustawienia dobrego dla wszystkich. Decyzja zależy od tego, czego chcesz od systemów AI: by Cię znajdowały i cytowały, by treści nie trafiały do trenowania, czy jednego i drugiego naraz. Potraktuj tabelę jako punkt wyjścia, a potem przetestuj wynik.
| Twoja sytuacja | Rozsądne podejście w robots.txt | Na co uważać |
|---|---|---|
| Chcesz pojawiać się w odpowiedziach AI i wyszukiwaniu (usługi, firma lokalna, B2B, sklep) | Zezwól OAI-SearchBot, PerplexityBot i ChatGPT-User; boty do trenowania zezwól lub pozostaw bez wpisu | Blokada botów wyszukiwania wyklucza Cię z puli, w której mogliby Cię zacytować; nie kopiuj przypadkiem listy „zablokuj wszystko” |
| Nie przeszkadza Ci, że Cię znajdują, ale nie chcesz, by tekst szedł do trenowania | Zablokuj GPTBot, ClaudeBot (jeśli chcesz, także anthropic-ai), CCBot, Google-Extended, Applebot-Extended; boty wyszukiwania i użytkownika zostaw otwarte | Nie działa wstecz; część robotów może ją ignorować; taką politykę stosuje 8,4% witryn w naszych danych |
| Treści płatne lub tylko dla członków, oryginalne badania, archiwum medialne | Zablokuj wszystkie boty do trenowania, o botach wyszukiwania decyduj osobno i egzekwuj regułami CDN lub zapory, nie tylko robots.txt | Robots.txt nie zatrzyma robota, który go ignoruje; sprawdzaj logi serwera |
| Nie chcesz niczego od systemów AI | Zablokuj wszystkie dziesięć śledzonych botów (tak robi 13,2% witryn blokujących) i dodaj reguły na poziomie serwera | Nie używaj ogólnego Disallow: / dla *: zamyka ono witrynę także przed wyszukiwarkami |
| Nie masz jeszcze wyraźnej polityki | Zostaw, jak jest, dodaj wiersz Sitemap, notuj, które boty odwiedzają serwer, i wróć do tematu za kwartał | Nieprzemyślana lista skopiowana z sieci to najczęstsze źródło przypadkowych blokad |
Krótka lista kontrolna:
- Otwórz własny
/robots.txti poszukaj dziesięciu nazw powyżej. Nasz bezpłatny analizator robots.txt analizuje plik i pokazuje, które reguły dotyczą którego bota. - Zapisz politykę jednym zdaniem (na przykład „zezwalamy botom wyszukiwania i odpowiedzi, odmawiamy trenowaniu”) i zbuduj plik na jej podstawie. Generator robots.txt utworzy grupy za Ciebie.
- Upewnij się, że nie zablokowałeś przypadkiem Googlebota: reguły dla AI powinny nazywać user-agenty AI, a nie
*. - Jeśli publikujesz llms.txt, traktuj go jak dokumentację: tytuł, krótkie streszczenie i lista kluczowych stron z jednowierszowymi opisami, serwowana jako zwykły tekst lub Markdown ze statusem 200. Nie mamy do tego narzędzia, a strona-zaślepka ze statusem 200 jest gorsza niż 404, bo roboty nie odróżnią jej od pliku.
- Przeglądaj politykę, gdy dostawca zmienia dokumentację: nazwy user-agentów się zmieniają (anthropic-ai jest tego przykładem).
Metodologia i zastrzeżenia
Dane pochodzą z naszego własnego skanowania TRI 6 000 witryn w dniach 15–16 listopada 2026 roku: korpus witryn pojawiających się w wynikach Google dla zapytań, które śledzimy, plus witryny użytkowników i próba kontrolna. Nazwy hostów w eksporcie zastąpiono haszami, publikujemy wyłącznie agregaty. Wyłączyliśmy 661 witryn (11,0%), które odpowiedziały robotowi stroną ochrony przed botami (WAF; 420 z nich to Cloudflare), 178 niedostępnych witryn (3,0%) i 90 z innymi błędami serwera lub HTTP (1,5%). 655 witryn z WAF, które sprawdziliśmy ponownie po siedmiu dniach, znów było zablokowanych. W obliczeniach jest 5 071 witryn; robots.txt znaleziono u 4 772 (94,1%), a odsetki w częściach o robots opierają się na tych 4 772. Udziały llms.txt opierają się na wszystkich 5 071.
Witryna „blokuje” bota, gdy przeanalizowany robots.txt zabrania user-agentowi bota dostępu do całej witryny (Disallow: /). Dziesięć user-agentów to te z tabeli rankingu. Blokad częściowych (folder) nie liczymy jako blokad. Content-Signal i ogólne Disallow: / dla wszystkich robotów liczymy osobno. Kryterium „prawdziwego pliku” llms.txt: status 200, treść niebędąca HTML, brak przekierowania na inną stronę.
Ograniczenia:
- Próba nie jest losowa. Zbudowano ją z witryn pojawiających się w wynikach wyszukiwania dla naszych zapytań, więc jest przesunięta ku witrynom aktywnym w SEO. Nie przenoś odsetków na cały internet.
- Witryny za WAF są wyłączone, a to prawdopodobnie witryny lepiej chronione i większe; ich polityka robots.txt może być inna.
- Robots.txt pokazuje intencję właściciela, a nie to, czy bot jej przestrzega.
- Reguły odczytujemy z jednego momentu; witryny zmieniają pliki, a dostawcy AI dodają i przemianowują roboty. Śledzimy dziesięć user-agentów i nie obejmujemy innych (na przykład nowszych osobnych agentów, które niektórzy dostawcy opisują dla żądań użytkowników).
- CMS ustalamy po metatagu generator, którego większość witryn nie publikuje; język pochodzi z atrybutu
langw HTML. Podział według strefy domenowej (TLD) jest niedostępny, bo nazwy hostów są zahaszowane. - Korelacje (blokowanie i llms.txt, CMS i blokowanie) nie są przyczynami.
Dwie uwagi do liczb. W naszym roboczym szkicu z 16.11 379 witryn opisano jako blokujące „wszystkie 7 głównych botów”; ostateczny wynik to 379 witryn blokujących siedem lub więcej z dziesięciu śledzonych botów, z czego 95 blokuje wszystkie dziesięć. Szkic porównywał też 15,6% z 23,6% dla llms.txt, gdzie druga liczba obejmowała wszystkie witryny bez blokad AI, także te bez robots.txt; tutaj podstawa jest ta sama (witryny z robots.txt), co daje 25,1%.
FAQ
Czy blokować boty AI w robots.txt?
To zależy od celu. Jeśli chcesz pojawiać się w odpowiedziach AI, zostaw otwarte boty wyszukiwania (OAI-SearchBot, PerplexityBot). Jeśli sprzeciwiasz się użyciu tekstu do trenowania, zablokuj boty do trenowania (GPTBot, ClaudeBot, Google-Extended, CCBot, Applebot-Extended). W naszej próbie 4 772 witryn z robots.txt co najmniej jednego bota AI blokuje 15,1%, a wyłącznie boty do trenowania 8,4%.
Czy zniknę z ChatGPT, jeśli zablokuję GPTBot?
Nie. GPTBot to robot OpenAI do trenowania. Wyniki wyszukiwania ChatGPT korzystają z OAI-SearchBot, a żądania użytkowników z ChatGPT-User. Spośród 549 witryn w naszych danych, które zablokowały GPTBot, 69,6% zostawiło OAI-SearchBot otwartego.
Czy blokada Google-Extended wpływa na pozycje w Google?
Google opisuje Google-Extended jako osobny token, który steruje użyciem treści dla Gemini; nie jest częścią Googlebota i nie steruje skanowaniem ani indeksowaniem w Wyszukiwarce. Żadnego wpływu na pozycje, ani dodatniego, ani ujemnego, nie twierdzimy.
Czy boty AI przestrzegają robots.txt?
Więksi dostawcy twierdzą, że tak, z zastrzeżeniem, że według OpenAI odwiedziny ChatGPT-User z inicjatywy użytkownika mogą go nie przestrzegać. Robots.txt to standard dobrowolny, a część właścicieli witryn zgłasza roboty, które go ignorują. Aby blokada działała, użyj reguł CDN lub serwera.
Czy potrzebuję pliku llms.txt?
Żaden dostawca tego nie wymaga i nie znamy potwierdzonego użycia przez duży system AI. Prawdziwy plik publikuje 22,5% z 5 071 sprawdzonych witryn. Dodanie go jest tanie i nieszkodliwe, jeśli jest aktualny, ale nie oczekuj, że zmieni widoczność.
Jak sprawdzić, które boty AI blokuje moja witryna?
Otwórz /robots.txt i poszukaj user-agentów z tego artykułu albo wklej plik do naszego analizatora robots.txt. Aby utworzyć nowy plik, użyj generatora robots.txt.
Źródła
- OpenAI, Overview of OpenAI crawlers: platform.openai.com/docs/bots
- Anthropic, artykuł pomocy o robocie i robots.txt: support.anthropic.com
- Google Search Central, Google's common crawlers (Google-Extended): developers.google.com
- Apple, About Applebot: support.apple.com/en-us/119829
- Perplexity, Perplexity crawlers: docs.perplexity.ai/guides/bots
- Common Crawl, CCBot: commoncrawl.org/ccbot
- IETF, RFC 9309, Robots Exclusion Protocol: rfc-editor.org/rfc/rfc9309
- Propozycja llms.txt: llmstxt.org
- Content Signals Policy: contentsignals.org
Jak cytować
PromoPilot (2026). Ile witryn blokuje boty AI w robots.txt: 5 071 witryn, listopad 2026. Dane z 15–16 listopada 2026. CC BY 4.0: https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-robots-5071-sites-2026-11.csv . Artykuł: https://promopilot.link/pl/blog/ile-witryn-blokuje-boty-ai-w-robots-txt-5071-witryn-2026
Pobierz dane
Tabele zbiorcze (CSV, licencja CC BY 4.0): https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-robots-5071-sites-2026-11.csv, a także tabele https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-blocked-count-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-bot-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-cms-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-html-lang-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/llms-txt-by-cms-2026-11.csv. Zawiera wyłącznie agregaty, bez projektów, domen i danych klientów.