
Generator robots.txt
Darmowy generator robots.txt: wybierz preset CMS (WordPress, WooCommerce, 1C-Bitrix, Laravel, Next.js oraz uwaga dla Shopify), dopisz własne reguły Allow/Disallow, zdecyduj, co z botami AI — zablokować trenowanie (GPTBot, ClaudeBot, Google-Extended…) i zostawić wyszukiwanie AI albo zablokować wszystkie — i dodaj Sitemap. Plik jest sprawdzany pod kątem typowych błędów i powstaje w przeglądarce, bez rejestracji.
Ustawienia
Zaznaczone boty dostaną „Disallow: /”. robots.txt to prośba, a nie zamek: uczciwe boty ją respektują, resztę zatrzyma tylko serwer lub CDN (np. blokowanie botów AI w Cloudflare).
robots.txt
Wgraj plik do katalogu głównego (https://twoja-strona/robots.txt) i sprawdź działający plik w teście robots.txt. Dostęp botów AI pokaże AI Visibility Checker, a krótki opis strony dla AI zbuduje generator llms.txt.
Najważniejsze fakty
robots.txt to plik tekstowy w katalogu głównym strony, w którym prosisz roboty, by nie wchodziły do niektórych sekcji. Wybierz preset (WordPress, WooCommerce, Bitrix, Next.js i inne), dodaj własne ścieżki i Sitemap, opcjonalnie zablokuj boty AI, po czym skopiuj wynik. To prośba, a nie ochrona: uczciwe boty ją respektują, inne nie, a zablokowana strona może i tak trafić do indeksu.
- Cena
- Za darmo
- Rejestracja
- Niewymagana
- Przetwarzanie
- W Twojej przeglądarce — nic nie trafia na serwer
- Dane wejściowe
- Preset strony, ścieżki Disallow i Allow (po jednej w wierszu), adres Sitemap, pole Crawl-delay i lista botów AI
- Limity
- Bez rejestracji i bez limitów; tylko generowanie i sprawdzanie tekstu, plik trzeba samodzielnie wgrać na stronę
- Wynik
- Gotowy tekst robots.txt z przyciskiem Kopiuj lub Pobierz oraz lista ostrzeżeń (konflikt Allow i Disallow, zablokowanie całej strony, Crawl-delay)
- Ostatnia aktualizacja
Wideo: jak to działa 0:56 po angielsku, napisy po polsku

Generator robots.txt za darmo: presety CMS + blokada botów AI (GPTBot, ClaudeBot)
Wygeneruj plik robots.txt za darmo: presety CMS (WordPress, WooCommerce, Shopify…), własne reguły, linia Sitemap i gotowe presety dla robotów AI.
Transkrypcja wideo
Write a robots.txt file, and decide what to do about AI crawlers. Here's a free generator that does both. Pick a site preset: WordPress, WooCommerce, Shopify and others. I'll choose WordPress, and the rules for its admin area and search pages appear on the right. Then the AI crawlers section. The preset, Block AI training, allow AI search, disallows the training bots like GPTBot and ClaudeBot, but leaves the search bots alone. Add a sitemap line, and download the file. Robots.txt is a request, not access control. It blocks crawling, not indexing. Blocking Google-Extended doesn't hurt your Google rankings. Free, no sign-up. The link is in the description. Subscribe for more free tools.
Jak to wygląda
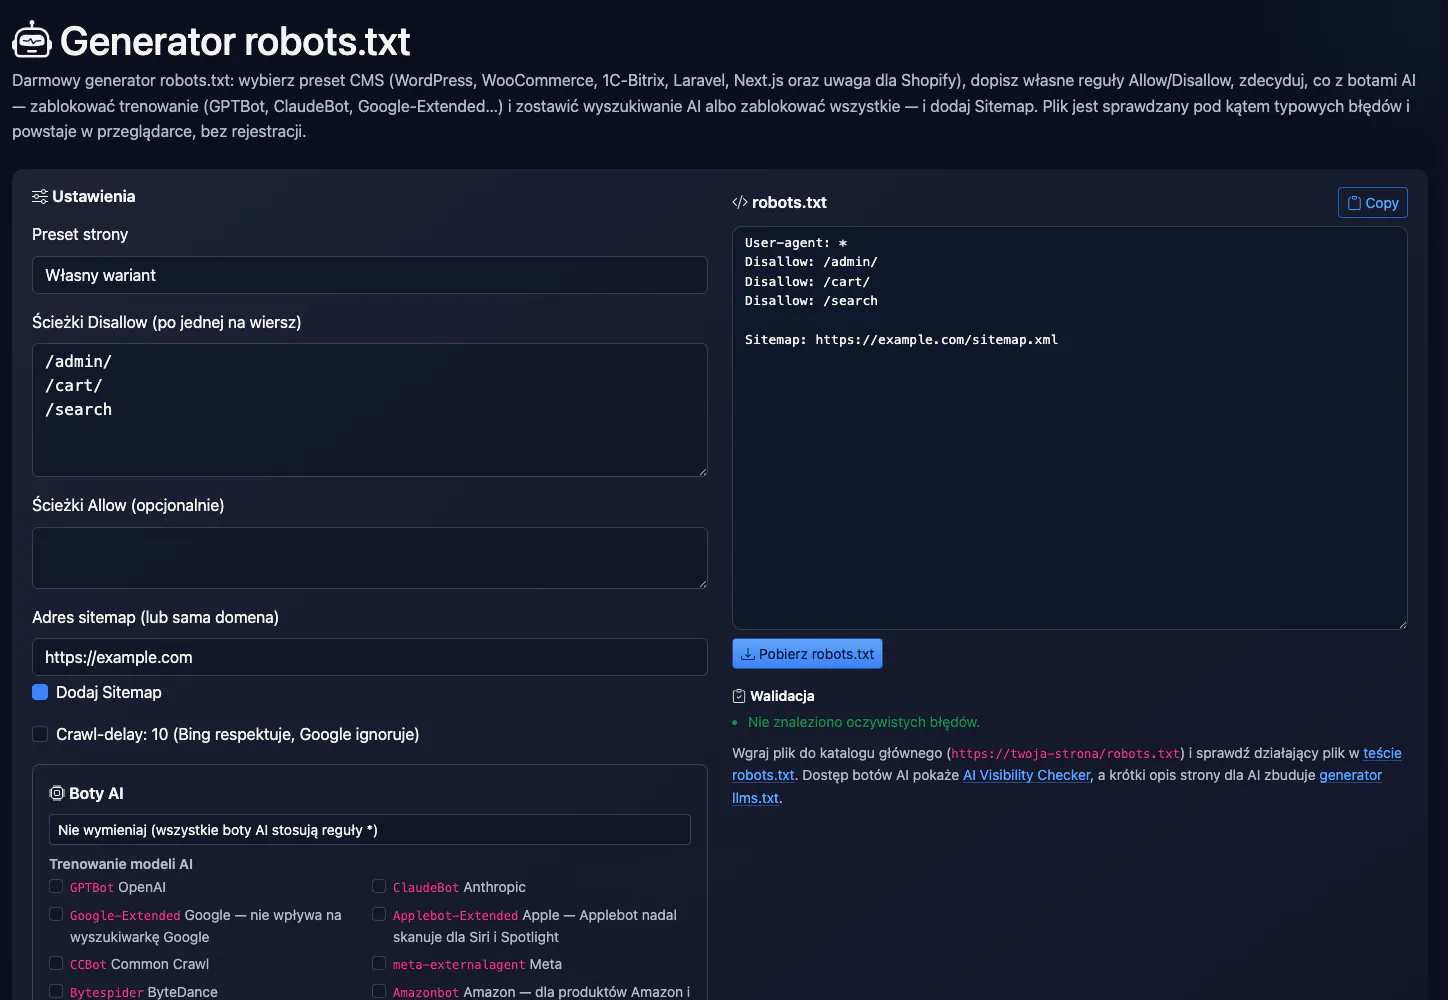
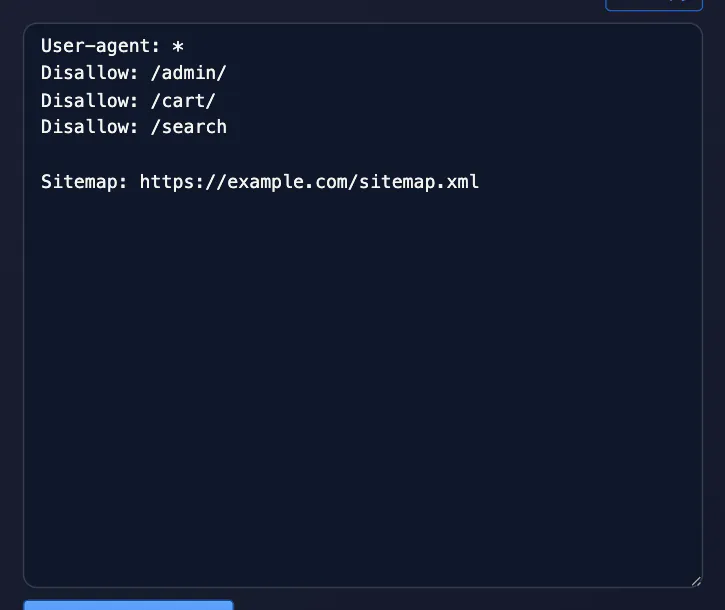
Generator robots.txt online
Generator robots.txt tworzy plik reguł dla wyszukiwarek i botów AI: presety dla WordPress, WooCommerce, 1C-Bitrix, Laravel i Next.js, uwaga dla Shopify, własne ścieżki Allow/Disallow, linia Sitemap i osobny blok dla crawlerów AI. Boty trenujące modele (GPTBot, ClaudeBot, Google-Extended i inne) można zablokować bez ruszania botów wyszukiwania AI, które linkują do Twojej strony. Wynik jest od razu sprawdzany pod kątem typowych błędów.
Jak korzystać
- Wybierz preset swojego CMS lub „Własny” i popraw ścieżki Allow i Disallow
- Zdecyduj, co z botami AI: nie wymieniać, zablokować trenowanie albo wszystkie
- Dodaj adres sitemap i przejrzyj ostrzeżenia pod plikiem
- Pobierz robots.txt, wgraj do katalogu głównego i sprawdź działający plik
FAQ
Dla kogo i typowe zastosowania
- Strona na WordPressie lub Bitrix. Wybierz preset z typowymi ścieżkami technicznymi i dodaj adres Sitemap.
- Blokowanie wyszukiwarki, filtrów i koszyka. Wpisz własne ścieżki ze wzorcami
*i$, np./*?sort=. - Decyzja o botach AI. Zablokuj tylko trenowanie modeli albo też wyszukiwanie AI, po decyzji, czy zależy Ci na widoczności w odpowiedziach AI.
Uczciwe ograniczenia
- robots.txt to prośba, a nie zamek. Nieuczciwe boty go ignorują; OpenAI i Perplexity same piszą, że przy zapytaniach na prośbę użytkownika plik może nie obowiązywać.
- Zablokowana strona może zostać w indeksie. Aby usunąć ją z wyników, potrzebny jest noindex, a nie Disallow.
- Google ignoruje Crawl-delay. Bing go respektuje; Google steruje częstotliwością inaczej.
- Shopify. Platforma sama generuje robots.txt, więc reguły zmienia się przez szablon robots.txt.liquid, a nie wgraniem pliku.
- Plik musi leżeć w katalogu głównym hosta. Każda subdomena i protokół potrzebują własnego pliku; generator niczego nie publikuje i nie sprawdza działającej strony.
Powiązane: checker robots.txt, generator sitemap, widoczność w AI, llms.txt.
PromoPilot i alternatywy: porównanie
Porównujemy tylko to, co potwierdzono na oficjalnych stronach usług. Gdy nie udało się potwierdzić faktu, w komórce jest „—”.
| Parametr | PromoPilot | Google Search Central: спецификация robots.txt |
|---|---|---|
| Presety CMS | ✓ WordPress, WooCommerce, Bitrix, Laravel, Next.js | ✗ |
| Lista botów AI | ✓ 14 botów | ✗ |
| Kontrola konfliktów reguł | ✓ | Zasada: wygrywa najbardziej szczegółowa, przy konflikcie mniej restrykcyjna |
| Działa w przeglądarce | ✓ | — |
Tabelę można przewinąć w bok
Gdzie jesteśmy słabsi: nie sprawdzamy opublikowanego pliku ani konkretnych adresów, nie ma presetu dla Joomli, Drupala i innych CMS, a listę botów AI trzeba okresowo porównywać z oficjalnymi stronami operatorów.
Kiedy wybrać PromoPilot: Gdy chcesz szybko złożyć poprawny robots.txt z presetu CMS i sprawdzić typowe błędy. Do kontroli opublikowanego pliku i testowania adresów użyj checkera robots.txt lub Search Console.
Sprawdzono: . „—” oznacza brak potwierdzenia na oficjalnej stronie; warunki i ceny się zmieniają, sprawdź je na stronach usług.
Jak działa robots.txt
robots.txt to plik tekstowy w katalogu głównym (https://example.com/robots.txt). Składa się z grup: linia User-agent wskazuje bota, pod nią są reguły Allow i Disallow ze ścieżkami. Najważniejsze zasady przy pisaniu pliku:
- Bot stosuje tylko jedną grupę — najdokładniej pasującą do swojej nazwy. Jeśli GPTBot ma własną grupę, reguł dla
*już nie czyta. Dlatego generator nie tworzy grupy zAllow: /dla „dozwolonych” botów AI: otworzyłaby im/wp-admin/i wszystko, co zablokowano innym. - Wygrywa najdłuższe dopasowanie.
Allow: /wp-admin/admin-ajax.phpjest silniejsze niżDisallow: /wp-admin/. Przy remisie Google wybiera Allow. - Działają
*i$.Disallow: /*?sort=blokuje adresy z parametrem sortowania,Disallow: /*.pdf$— wszystkie PDF. - Linia
Sitemapnie należy do grup i musi być pełnym adresem. - Google nie obsługuje
Crawl-delay; Bing go respektuje. Google czyta najwyżej 500 KiB pliku.
Boty AI: kogo blokować i jaki ma to koszt
Boty AI dzielą się na trzy grupy i każda wymaga innej decyzji.
| Grupa | Boty | Jeśli zablokujesz |
|---|---|---|
| Trenowanie modeli | GPTBot (OpenAI), ClaudeBot (Anthropic), CCBot (Common Crawl), meta-externalagent (Meta), Bytespider (ByteDance), Amazonbot (Amazon) oraz tokeny Google-Extended i Applebot-Extended | Treści nie trafią do przyszłych zbiorów treningowych. Wyszukiwarka Google i Bing nie są tym objęte. |
| Wyszukiwanie AI | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Strona przestanie pojawiać się jako link w odpowiedziach ChatGPT Search, Claude i Perplexity — to utracony ruch. |
| Pobrania na prośbę użytkownika | ChatGPT-User, Claude-User, Perplexity-User | Asystent nie otworzy strony, nawet gdy użytkownik sam poda link. OpenAI i Perplexity zaznaczają, że te pobrania mogą nie respektować robots.txt. |
Przypadki szczególne. Google-Extended to nie bot, lecz token: stronę skanuje zwykły Googlebot, a blokada oznacza „nie używaj treści do trenowania i odpowiedzi Gemini”. Według dokumentacji Google nie wpływa na obecność w wyszukiwarce ani na ranking. Applebot-Extended działa tak samo: wyłącza treści z trenowania modeli Apple, a Applebot nadal skanuje stronę dla Siri, Spotlight i Safari. Amazonbot według Amazona służy ulepszaniu jego usług, a dane mogą być używane do trenowania modeli AI — dlatego jest w grupie trenowania.
Najczęstszy wybór to preset „Zablokuj trenowanie AI, zostaw wyszukiwanie AI”: treści nie idą do trenowania, a linki w odpowiedziach AI nadal przyprowadzają odwiedzających. Powstaje taki blok:
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: meta-externalagent
User-agent: Bytespider
User-agent: Amazonbot
Disallow: /
Po publikacji sprawdź, jak poszczególne boty AI widzą stronę, w AI Visibility Checker, a jeśli chcesz, by AI lepiej rozumiało serwis, dodaj plik llms.txt.
robots.txt to prośba, a nie zamek
Uczciwe boty go przestrzegają; technicznie nic nie zmusza pozostałych. Jeśli boty trzeba naprawdę zatrzymać, robi się to na serwerze lub w CDN. Cloudflare ma np. zarządzany robots.txt z regułami dla botów AI (na wszystkich planach) i osobne blokowanie botów na poziomie sieci. Nie używaj też robots.txt do ukrywania tajnych adresów: plik jest publiczny, a Disallow: /secret-admin/ tylko podpowiada, gdzie szukać.
Presety CMS: co zawierają i dlaczego
- WordPress: blokuje
/wp-admin/(pozaadmin-ajax.php), wewnętrzne wyszukiwanie/?s=i/search/oraz linki?replytocom=./wp-includes/i/wp-content/plugins/zostają otwarte: są tam CSS i JS potrzebne do renderowania. Plik w katalogu głównym zastępuje wirtualny robots.txt WordPressa; w Yoast SEO edytujesz go w Narzędzia → Edytor plików. - WooCommerce: do reguł WordPressa dodaje koszyk, zamówienie, konto i linki
?add-to-cart=. - 1C-Bitrix: blokuje folder systemowy
/bitrix/, ale zostawia otwarte/bitrix/templates/,/bitrix/js/,/bitrix/cache/,/bitrix/components/,/bitrix/panel/i/upload/, aby Google widział wygląd i obrazy. - Shopify: plik generuje platforma i nie da się wgrać własnego. Reguły zmienia się w szablonie
robots.txt.liquid(Sklep online → Motywy → Edytuj kod → Dodaj nowy szablon → robots); generator przygotuje dodatkowe linie. - Laravel: katalogiem głównym jest
/public, więc/vendori.envnie są dostępne i nie wpisujemy ich. Blokujemy strony logowania, rejestracji i resetu hasła. - Next.js: blokuje tylko
/api/. Folderu/_next/nie ruszaj — są tam JS i CSS stron.
Typowe błędy wykrywane przez walidację
- Ścieżka bez początkowego
/(Disallow: admin) — reguła niczego nie dopasuje. - Zablokowane CSS i JS lub foldery z nimi — Google nie wyrenderuje strony tak, jak widzi ją użytkownik.
Disallow: /dla wszystkich botów — dobre dla kopii testowej, zabójcze dla ruchu na działającej stronie.- Duplikaty, ta sama ścieżka w Allow i Disallow, spacje i znaki spoza ASCII w ścieżkach.
- Względny adres Sitemap albo brak linii Sitemap. Samą mapę zbuduje generator sitemap.
Pamiętaj: robots.txt blokuje skanowanie, nie indeksowanie. Aby usunąć stronę z wyników, zostaw ją dostępną i dodaj noindex. Działający plik sprawdź testem robots.txt — pokaże, jak reguły działają dla konkretnego adresu.
Popraw pozycje w wyszukiwarce
Problemy SEO mogą kosztować Cię ruch. Kaskadowy link building poprawi widoczność strony w wyszukiwarce.