Quantos sites bloqueiam bots de IA no robots.txt (5 071)
Em 15 e 16 de novembro de 2026 lemos o robots.txt de 4 772 sites: 15,1% deles (719) dizem a pelo menos um rastreador de IA para ficar fora do site inteiro com uma regra Disallow: /. O bot mais bloqueado é o Bytespider, da ByteDance (12,0%), seguido do CCBot, da Common Crawl (11,9%), e do GPTBot,…
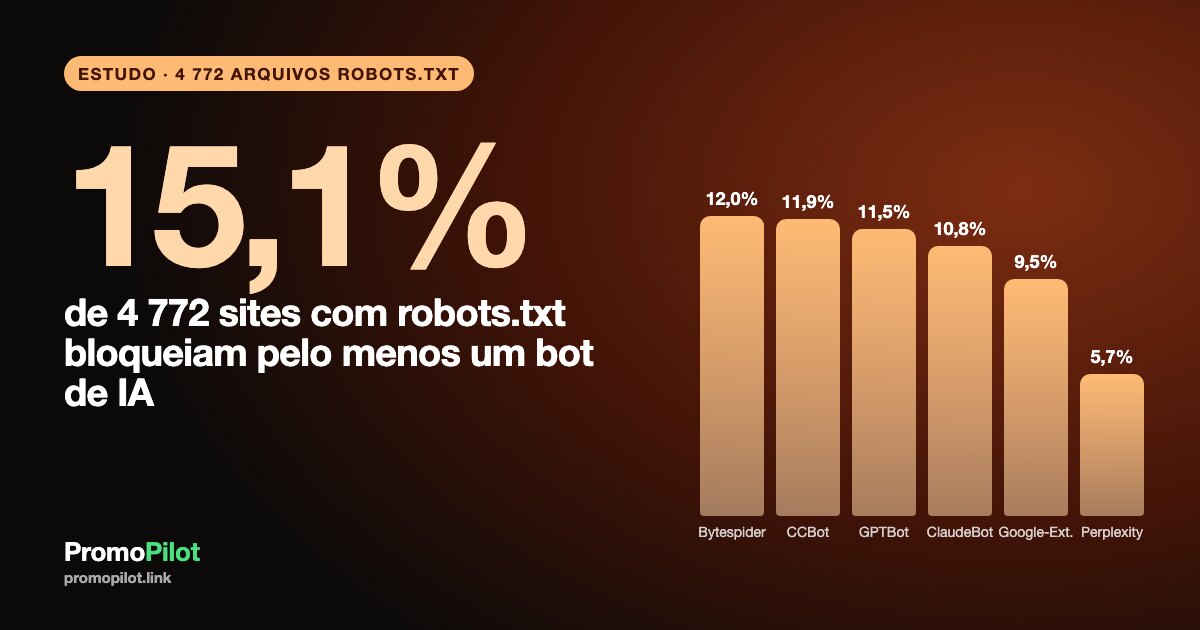
Em 15 e 16 de novembro de 2026 lemos o robots.txt de 4 772 sites: 15,1% deles (719) dizem a pelo menos um rastreador de IA para ficar fora do site inteiro com uma regra Disallow: /. O bot mais bloqueado é o Bytespider, da ByteDance (12,0%), seguido do CCBot, da Common Crawl (11,9%), e do GPTBot, da OpenAI (11,5%); os bots que buscam páginas para respostas ao vivo e busca com IA são bloqueados bem menos (OAI-SearchBot 3,6%). À parte: 22,5% de 5 071 sites servem um arquivo llms.txt real, e os sites que bloqueiam bots de IA o têm com menos frequência (15,6% contra 25,1%). A seguir: o ranking de bots, o que é cada bot e o que bloqueá-lo faz e não faz, o panorama do llms.txt, uma tabela de decisão para o seu site e a metodologia. Ressalva: a amostra não é aleatória (sites do nosso cache de resultados de busca), então os números descrevem esta amostra, não a web inteira.
Dados: rastreamento da PromoPilot de 6 000 sites, 15 e 16 de novembro de 2026 (verificação do llms.txt em 16 de novembro); foram excluídos 661 sites bloqueados por um WAF, 178 inacessíveis e 90 com outros erros, 5 071 no cálculo, robots.txt encontrado em 4 772
Números-chave
- 15,1% dos sites (719 de 4 772 com robots.txt) bloqueiam pelo menos um dos 10 bots de IA que acompanhamos. Entre eles, 121 (2,5% de todos os sites) também têm um
Disallow: /geral para todos os rastreadores, de modo que a parcela voltada especificamente a bots de IA é de 598 sites, 12,5%. - Ranking por bot: Bytespider 12,0%, CCBot 11,9%, GPTBot 11,5%, ClaudeBot 10,8%, Google-Extended 9,5%, anthropic-ai 8,8%, Applebot-Extended 8,2%, PerplexityBot 5,7%, ChatGPT-User 5,3%, OAI-SearchBot 3,6%.
- O bloqueio costuma ser tudo ou nada: dos 719 sites que bloqueiam, 379 (52,7%) bloqueiam 7 ou mais dos 10 bots, 95 (13,2%) bloqueiam todos os 10 e 100 (13,9%) bloqueiam exatamente um.
- Treinamento versus consulta ao vivo: 15,0% dos sites bloqueiam pelo menos um bot de treinamento, 6,6% bloqueiam pelo menos um bot de busca ou consulta e 8,4% bloqueiam apenas bots de treinamento. Dos 549 sites que bloqueiam o GPTBot, 382 (69,6%) deixam o OAI-SearchBot aberto.
- O Content-Signal (a diretiva do robots.txt para preferências de search, ai-input e ai-train) aparece em 5,4% dos sites (258); 90 deles o usam sem bloquear nenhum bot.
- llms.txt: arquivo real em 22,5% de 5 071 sites (1 139), llms-full.txt em 5,1% (259); 8,6% (435) respondem 200 com uma página HTML de preenchimento ou um redirecionamento, que não contamos; 63,5% retornam 404.
- Os sites que bloqueiam bots de IA servem llms.txt com menos frequência: 15,6% (112 de 719) contra 25,1% (1 019 de 4 053 que não bloqueiam), entre os sites com robots.txt.
- Por CMS (tag generator): 17,6% dos sites sem tag generator bloqueiam pelo menos um bot de IA, WordPress 9,3% (462 sites), Drupal 19,1% (47), outros CMS e construtores 5,3% (587).
Ranking: quantos sites bloqueiam cada bot de IA
Para cada site analisamos o robots.txt e registramos quais dos 10 user agents de IA estão proibidos de acessar o site inteiro. A base são os 4 772 sites em que um robots.txt foi encontrado (94,1% dos 5 071 que conseguimos ler). O ranking está abaixo.

| # | Bot | Sites que bloqueiam | Porcentagem de 4 772 |
|---|---|---|---|
| 1 | Bytespider | 571 | 12,0% |
| 2 | CCBot | 569 | 11,9% |
| 3 | GPTBot | 549 | 11,5% |
| 4 | ClaudeBot | 515 | 10,8% |
| 5 | Google-Extended | 452 | 9,5% |
| 6 | anthropic-ai | 421 | 8,8% |
| 7 | Applebot-Extended | 391 | 8,2% |
| 8 | PerplexityBot | 271 | 5,7% |
| 9 | ChatGPT-User | 254 | 5,3% |
| 10 | OAI-SearchBot | 173 | 3,6% |
Dois padrões se destacam. Primeiro: as sete primeiras posições são de bots coletados para treinar modelos, ou de tokens ligados ao treinamento; as três últimas estão ligadas à busca e às respostas. Os donos de sites bloqueiam com muito mais facilidade “o bot que treina com o meu conteúdo” do que “o bot que pode me enviar um visitante”. Segundo: o token legado anthropic-ai (8,8%) ainda é bloqueado quase tanto quanto o ClaudeBot (10,8%): 384 sites bloqueiam os dois e 552 (11,6% do total) bloqueiam pelo menos um dos dois, o que sugere que muitos robots.txt são copiados de listas prontas em vez de escritos bot a bot.
Para a maioria dos sites, o bloqueio é tudo ou nada
Os 719 sites que bloqueiam não escolhem bot por bot. Metade deles (379) bloqueia sete ou mais bots, 95 bloqueiam os dez e apenas 100 bloqueiam um.

Um esclarecimento sobre o próprio número. Nosso analisador considera um bot bloqueado quando a regra dele proíbe o site inteiro. 121 dos 719 sites também trazem um Disallow: / geral para todos os rastreadores, que fecha o site também aos buscadores (2,5% de todos os sites com robots.txt; alguns são sites em construção). Se você quer a parcela específica de bots de IA, subtraia esses: 598 sites, 12,5%.
Anatomia: o que é cada bot e o que bloqueá-lo faz e não faz
“Bloquear a IA” não é uma decisão só. Os dez user agents pertencem a três trabalhos diferentes: coletar páginas para treinar modelos, construir um índice de busca que responde perguntas com citações e buscar uma página agora mesmo porque uma pessoa pediu a um assistente. Bloquear cada um tem um efeito diferente. As descrições seguem a documentação pública dos fornecedores como a lemos em novembro de 2026; a documentação dos rastreadores muda, então confira as páginas indicadas antes de confiar em algum detalhe.
| Bot | Operado por | Função | O que bloqueá-lo faz | O que não faz |
|---|---|---|---|---|
| GPTBot | OpenAI | Rastreador de treinamento | Pede à OpenAI que não use suas páginas para treinar modelos futuros | Não tira você da busca do ChatGPT, que usa o OAI-SearchBot |
| OAI-SearchBot | OpenAI | Índice de busca para os resultados do ChatGPT | Pede à OpenAI que não inclua suas páginas nos recursos de busca | Não é um rastreador de treinamento; bloqueá-lo não interrompe o treinamento |
| ChatGPT-User | OpenAI | Busca uma página quando um usuário ou um GPT personalizado pede | Pede à OpenAI que não abra suas páginas a pedido de usuários | A OpenAI informa que as regras do robots.txt podem não valer para essas visitas iniciadas pelo usuário |
| ClaudeBot | Anthropic | Rastreador de treinamento | Pede à Anthropic que não colete suas páginas para treinamento | Não cobre o Claude-User (pedidos de usuários) nem o Claude-SearchBot (busca): a Anthropic os lista separadamente |
| anthropic-ai | Anthropic | Token antigo de treinamento | Token antigo. A documentação atual da Anthropic lista ClaudeBot, Claude-User e Claude-SearchBot; manter o anthropic-ai na lista não faz mal | Muitos sites o incluem por hábito |
| Google-Extended | Um token do robots.txt, não um rastreador separado; controla o uso do conteúdo no treinamento e no grounding do Gemini | Tira seu conteúdo desses usos do Gemini | Não muda o rastreamento nem a indexação do Google Search, e o Google informa que ele não governa recursos da Busca, como os AI Overviews | |
| Applebot-Extended | Apple | Um token; controla se o conteúdo rastreado pelo Applebot é usado para treinar os modelos da Apple | Tira seu conteúdo desse treinamento | O próprio Applebot continua rastreando para a busca da Siri e do Spotlight |
| PerplexityBot | Perplexity | Indexa páginas para a busca da Perplexity | Pede à Perplexity que não mostre suas páginas nos resultados | A Perplexity diz que ele não é usado para treinar modelos de base; visitas iniciadas pelo usuário usam outro agente |
| CCBot | Common Crawl | Constrói um arquivo aberto da web que muitos desenvolvedores de IA usam para treinar | Mantém páginas novas fora dos futuros conjuntos da Common Crawl | Não remove o que rastreamentos anteriores já guardaram |
| Bytespider | ByteDance | Rastreador para produtos e modelos da ByteDance | Pede à ByteDance que não rastreie o site | Alguns operadores de sites relatam que ele ignora o robots.txt; se isso importa, bloqueie também no servidor ou no CDN |
Quatro coisas que o robots.txt não faz
- É um pedido, não uma tranca. Um rastreador bem-comportado o lê; um mal-comportado não. Para impor um bloqueio, use as regras do CDN, do firewall ou do servidor web (os 661 sites que responderam ao nosso rastreador com uma página de bloqueio de WAF usam essa ferramenta mais forte).
- Não é retroativo. Afeta o rastreamento futuro. O conteúdo que um rastreador já coletou, ou que está em um arquivo antigo da Common Crawl, continua onde estava.
- Treinamento e respostas são chaves separadas. Bloquear os bots de treinamento (GPTBot, ClaudeBot, Google-Extended) é uma escolha diferente de bloquear os bots que decidem se sua página pode ser citada em uma resposta de IA (OAI-SearchBot, PerplexityBot). Em nossos dados, 8,4% dos sites bloqueiam apenas bots de treinamento, 6,6% bloqueiam os dois grupos e somente 4 sites bloqueiam só os bots de consulta.
- Não esconde uma página do Google Search. O Google-Extended é separado do Googlebot. Bloquear o primeiro deixa o rastreamento de busca comum intacto, enquanto um
Disallow: /geral ou um bloqueio do Googlebot fecha o site para a busca.
Onde os sites se dividem: treinamento versus consulta
Veja a OpenAI. Dos 549 sites que bloqueiam o GPTBot, 249 (45,4%) bloqueiam também o ChatGPT-User e 167 (30,4%) também o OAI-SearchBot; 382 (69,6%) bloqueiam o rastreador de treinamento, mas deixam o de busca aberto. É uma política coerente: recusar o treinamento e continuar elegível para aparecer na busca do ChatGPT. O par do Google se comporta de modo parecido: 121 sites bloqueiam o GPTBot sem o Google-Extended, e 24 bloqueiam o Google-Extended sem o GPTBot.
A diretiva mais recente Content-Signal expressa a mesma divisão em uma única linha, com valores yes ou no separados para search, ai-input e ai-train. Aparece em 5,4% dos sites (258). Desses, 168 (65,1%) também bloqueiam pelo menos um bot de IA pelo nome, e 90 usam só o sinal. Registramos apenas que a diretiva existe; se um rastreador específico a respeita cabe ao rastreador.
llms.txt: quantos sites têm um arquivo real
O llms.txt é uma proposta de 2024 de um arquivo Markdown em /llms.txt que lista as páginas mais úteis de um site para modelos de linguagem, com descrições curtas; o llms-full.txt é a variante mais longa, com o conteúdo embutido. Não é um padrão oficial e, até onde sabemos na data em que escrevemos, nenhum grande fornecedor de IA confirmou que usa esses arquivos para consulta ou classificação, então trate-o como documentação barata para máquinas, não como uma alavanca de visibilidade. Verificamos mesmo assim, porque é a outra metade da pergunta “o que eu digo à IA”.
Contamos um “arquivo real” somente quando o endereço responde 200, não é uma página HTML e não redireciona para outra página. Isso exclui 435 sites (8,6%) que respondem 200 com uma página HTML (um soft 404 ou um preenchimento) ou um redirecionamento.

| Medida | Sites | Porcentagem |
|---|---|---|
| Arquivo llms.txt real | 1 139 | 22,5% de 5 071 |
| Arquivo llms-full.txt real (todos têm também llms.txt) | 259 | 5,1% de 5 071 |
| 200 com uma página HTML de preenchimento ou um redirecionamento (não contado) | 435 | 8,6% de 5 071 |
| 404 | 3 218 | 63,5% de 5 071 |
| llms.txt real entre os sites que bloqueiam bots de IA | 112 de 719 | 15,6% |
| llms.txt real entre os que não bloqueiam (robots.txt encontrado) | 1 019 de 4 053 | 25,1% |
Como são os arquivos reais: a mediana é de 5 922 bytes e o percentil 90 de 56 975 bytes; 77,9% começam com um título (H1), como o formato sugere; 89,0% contêm pelo menos um link Markdown (o arquivo mediano tem 24); 10,3% não têm nenhum e são, na prática, texto simples. 11,6% são servidos como text/markdown, o resto como text/plain.
A relação com o bloqueio é apenas uma correlação: os sites que bloqueiam bots de IA têm menos probabilidade de publicar um arquivo escrito para sistemas de IA (15,6% contra 25,1%), o que combina com uma leitura simples: esses sites escolhem não interagir com a IA e os demais escolhem interagir. Não podemos dizer que uma coisa causa a outra; alguns arquivos vêm de plugins e construtores que os criam automaticamente (a parcela é de 35,3% entre os sites em outros CMS e construtores, 25,5% no WordPress e 20,6% sem tag generator). Nossa amostra também é enviesada para sites que aparecem nos resultados de busca.
Por CMS e por idioma
O CMS vem da meta tag generator; 3 598 dos 4 772 sites não a publicam, e esse é o maior grupo e o que mais bloqueia. Grupos com menos de 30 sites não são mostrados. Nota: os nomes de host em nossos dados são hasheados, então uma divisão por zona de domínio (TLD) não é possível; mostramos o idioma da página declarado no HTML como o sinal geográfico mais próximo.

| CMS (tag generator) | Sites com robots.txt | Bloqueiam algum bot de IA | Bloqueiam o GPTBot | Arquivo llms.txt (de todos os sites do grupo) |
|---|---|---|---|---|
| Sem tag generator | 3 598 | 17,6% (632) | 13,4% | 20,6% (793 de 3 856) |
| Outro CMS ou construtor | 587 | 5,3% (31) | 4,6% | 35,3% (218 de 618) |
| WordPress | 462 | 9,3% (43) | 7,1% | 25,5% (120 de 471) |
| Drupal | 47 | 19,1% (9) | 8,5% | 10,6% (5 de 47) |
| MediaWiki | 42 | 4,8% (2) | 2,4% | 2,4% (1 de 42) |
| Joomla | 36 | 5,6% (2) | 2,8% | 5,4% (2 de 37) |
Leia a divisão por CMS com cuidado. Sites sem tag generator costumam ser desenvolvimentos sob medida, lojas e sites comerciais maiores, e esses donos são os que mais provavelmente têm uma política; sites em plataformas prontas costumam manter o robots.txt padrão da plataforma. A diferença diz tanto respeito a quem administra o site quanto ao software que ele usa. Os grupos de Drupal e MediaWiki são pequenos (47 e 42 sites).
| Idioma do HTML | Sites com robots.txt | Bloqueiam algum bot de IA | Bloqueiam o GPTBot |
|---|---|---|---|
| en | 1 655 | 12,6% (208) | 8,6% |
| ru | 823 | 7,2% (59) | 4,5% |
| uk | 516 | 10,1% (52) | 5,6% |
| sem idioma declarado | 505 | 34,7% (175) | 32,7% |
| sv | 336 | 13,7% (46) | 11,3% |
| de | 311 | 19,6% (61) | 17,4% |
| pl | 102 | 16,7% (17) | 9,8% |
| he | 89 | 11,2% (10) | 5,6% |
| es | 85 | 22,4% (19) | 20,0% |
| fr | 72 | 13,9% (10) | 11,1% |
| nl | 35 | 14,3% (5) | 2,9% |
Os sites em alemão e em espanhol desta amostra bloqueiam com mais frequência que os sites em inglês, russo e ucraniano. O grupo sem idioma declarado se destaca com 34,7%, mais que o dobro da média da amostra; não analisamos o motivo. Trate a tabela de idiomas como uma descrição desta amostra, não como uma estatística nacional: a amostra vem das consultas de busca que acompanhamos.
Como decidir para o seu site
Não existe uma configuração certa para todos. A decisão depende do que você quer dos sistemas de IA: ser encontrado e citado, manter o conteúdo fora do treinamento, ou as duas coisas ao mesmo tempo. Use a tabela como ponto de partida e depois teste o resultado.
| Sua situação | Postura razoável no robots.txt | Atenção a |
|---|---|---|
| Você quer aparecer em respostas e buscas de IA (negócio de serviços, negócio local, B2B, loja) | Permita OAI-SearchBot, PerplexityBot e ChatGPT-User; permita os bots de treinamento ou deixe-os sem menção | Bloquear os bots de busca tira você do grupo que poderia citá-lo; não copie por acidente uma lista de “bloquear tudo” |
| Você não se importa de ser encontrado, mas não quer seu texto usado para treinamento | Bloqueie GPTBot, ClaudeBot (e anthropic-ai, se quiser), CCBot, Google-Extended, Applebot-Extended; mantenha liberados os bots de busca e de usuário | Não é retroativo; alguns rastreadores podem ignorar; é a política que 8,4% dos sites em nossos dados seguem |
| Conteúdo pago ou só para membros, pesquisa original, arquivo de mídia | Bloqueie todos os bots de treinamento, decida caso a caso sobre os de consulta e imponha com regras de CDN ou firewall, não só com o robots.txt | O robots.txt não para um rastreador que o ignora; confira os logs do servidor |
| Você não quer nada dos sistemas de IA | Bloqueie os dez bots acompanhados (13,2% dos sites que bloqueiam fazem isso) e adicione regras no nível do servidor | Não use um Disallow: / geral para *: ele fecha o site também aos buscadores |
| Você ainda não tem uma política clara | Deixe como está, adicione uma linha Sitemap, anote quais bots acessam seu servidor e reveja em um trimestre | Uma lista copiada sem revisão é a fonte mais comum de bloqueios acidentais |
Uma lista de verificação curta:
- Abra o seu
/robots.txte procure os dez nomes acima. Nosso analisador de robots.txt gratuito interpreta o arquivo e mostra quais regras valem para qual bot. - Escreva a política em uma frase (por exemplo, “permitir bots de busca e resposta, recusar treinamento”) e monte o arquivo a partir dela. O gerador de robots.txt cria os grupos para você.
- Confirme que você não bloqueou o Googlebot por acidente: as regras de IA devem nomear os user agents de IA, não
*. - Se você publica um llms.txt, trate-o como documentação: um título, um resumo curto e uma lista de páginas-chave com descrições de uma linha, servido como texto simples ou Markdown com status 200. Não temos uma ferramenta para isso, e uma página de preenchimento que retorna 200 é pior que um 404, porque os rastreadores não a distinguem de um arquivo.
- Reveja a política quando um fornecedor mudar a documentação; os nomes dos user agents mudam (anthropic-ai é um exemplo).
Metodologia e ressalvas
Os dados vêm do nosso próprio rastreamento TRI de 6 000 sites em 15 e 16 de novembro de 2026: o corpus de sites que aparecem nos resultados do Google para as consultas que acompanhamos, mais sites de usuários e uma amostra de controle. Os nomes de host na exportação são substituídos por hashes e publicamos apenas agregados. Excluímos 661 sites (11,0%) que responderam ao rastreador com uma página de proteção contra bots (WAF; 420 deles Cloudflare), 178 sites inacessíveis (3,0%) e 90 com outros erros de servidor ou HTTP (1,5%). Os 655 sites bloqueados por WAF que tentamos de novo após sete dias estavam bloqueados outra vez. O cálculo abrange 5 071 sites; o robots.txt foi encontrado em 4 772 (94,1%) e as porcentagens das seções de robots usam esses 4 772. As porcentagens de llms.txt usam todos os 5 071.
Um site “bloqueia” um bot quando o robots.txt analisado proíbe o user agent do bot de acessar o site inteiro (Disallow: /). Os dez user agents são os da tabela do ranking. Bloqueios parciais (uma pasta) não são contados como bloqueios. Content-Signal e um Disallow: / geral para todos os rastreadores são contados à parte. O critério de “arquivo real” do llms.txt é: status 200, conteúdo que não seja HTML, sem redirecionamento para outra página.
Limites:
- A amostra não é aleatória. Ela é montada com sites que aparecem nos resultados de busca das nossas consultas, então tende a sites ativos em SEO. Não transfira as porcentagens para a web inteira.
- Sites atrás de um WAF estão excluídos, e esses provavelmente são sites mais protegidos e maiores; a política de robots.txt deles pode ser diferente.
- O robots.txt mostra a intenção do dono, não se um bot a cumpre.
- Lemos as regras em um único instante; os sites mudam seus arquivos, e os fornecedores de IA adicionam e renomeiam rastreadores. Acompanhamos dez user agents e não cobrimos outros (por exemplo, os agentes separados mais recentes que alguns fornecedores documentam para pedidos de usuários).
- O CMS vem da meta tag generator, que a maioria dos sites não publica; o idioma vem do atributo
langdo HTML. A divisão por zona de domínio (TLD) não está disponível porque os nomes de host são hasheados. - Correlações (bloqueio e llms.txt, CMS e bloqueio) não são causas.
Duas notas sobre os números. Nosso rascunho de trabalho de 16.11 descrevia 379 sites como bloqueando “todos os 7 bots principais”; a contagem final é de 379 sites que bloqueiam sete ou mais dos dez bots acompanhados, dos quais 95 bloqueiam os dez. O rascunho também comparava 15,6% com 23,6% para o llms.txt, em que o segundo número usava todos os sites sem bloqueios de IA, incluindo os sem robots.txt; aqui a base é a mesma (sites com robots.txt), o que dá 25,1%.
FAQ
Devo bloquear bots de IA no robots.txt?
Depende do que você quer. Se quer ser citado em respostas de IA, mantenha liberados os bots de busca (OAI-SearchBot, PerplexityBot). Se você se opõe a que seu texto seja usado para treinamento, bloqueie os bots de treinamento (GPTBot, ClaudeBot, Google-Extended, CCBot, Applebot-Extended). Na nossa amostra de 4 772 sites com robots.txt, 15,1% bloqueiam pelo menos um bot de IA e 8,4% bloqueiam apenas bots de treinamento.
Vou sumir do ChatGPT se bloquear o GPTBot?
Não. O GPTBot é o rastreador de treinamento da OpenAI. Os resultados de busca do ChatGPT usam o OAI-SearchBot, e os pedidos de usuários usam o ChatGPT-User. Dos 549 sites em nossos dados que bloqueiam o GPTBot, 69,6% deixam o OAI-SearchBot aberto.
Bloquear o Google-Extended afeta minhas posições no Google?
O Google documenta o Google-Extended como um token separado que controla o uso do conteúdo para o Gemini; ele não faz parte do Googlebot e não governa o rastreamento nem a indexação da Busca. Não afirmamos nenhum efeito nas posições, nem positivo nem negativo.
Os bots de IA obedecem ao robots.txt?
Os grandes fornecedores dizem que seus rastreadores obedecem, com a ressalva de que a OpenAI informa que as visitas do ChatGPT-User iniciadas pelo usuário podem não o seguir. O robots.txt é um padrão voluntário, e alguns donos de sites relatam rastreadores que o ignoram. Para impor um bloqueio, use as regras do CDN ou do servidor.
Preciso de um arquivo llms.txt?
Nenhum fornecedor exige, e não conhecemos um uso confirmado por um grande sistema de IA. 22,5% dos 5 071 sites que verificamos publicam um. É barato de adicionar e inofensivo se for mantido exato, mas não espere que mude a visibilidade.
Como posso verificar quais bots de IA o meu site bloqueia?
Abra /robots.txt e procure os user agents citados neste artigo, ou cole o arquivo em nosso analisador de robots.txt. Para criar um arquivo novo, use o gerador de robots.txt.
Fontes
- OpenAI, Overview of OpenAI crawlers: platform.openai.com/docs/bots
- Anthropic, artigo de ajuda sobre o rastreador e o robots.txt: support.anthropic.com
- Google Search Central, Google's common crawlers (Google-Extended): developers.google.com
- Apple, About Applebot: support.apple.com/en-us/119829
- Perplexity, Perplexity crawlers: docs.perplexity.ai/guides/bots
- Common Crawl, CCBot: commoncrawl.org/ccbot
- IETF, RFC 9309, Robots Exclusion Protocol: rfc-editor.org/rfc/rfc9309
- Proposta llms.txt: llmstxt.org
- Content Signals Policy: contentsignals.org
Como citar
PromoPilot (2026). Quantos sites bloqueiam bots de IA no robots.txt: 5 071 sites, novembro de 2026. Dados de 15 e 16 de novembro de 2026. CC BY 4.0: https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-robots-5071-sites-2026-11.csv . Artigo: https://promopilot.link/pt/blog/quantos-sites-bloqueiam-bots-de-ia-no-robots-txt-5071-sites-2026
Baixar os dados
As tabelas agregadas (CSV, licença CC BY 4.0): https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-robots-5071-sites-2026-11.csv, além das tabelas https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-blocked-count-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-bot-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-cms-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-html-lang-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/llms-txt-by-cms-2026-11.csv. Contém apenas agregados, sem projetos, domínios ou dados de clientes.