Скільки сайтів закривають ШІ-ботів у robots.txt, 5 071 сайт
15–16 листопада 2026 року ми прочитали robots.txt у 4 772 сайтів: 15,1% з них (719) правилом Disallow: / закривають весь сайт щонайменше від одного ШІ-краулера. Найчастіше закривають Bytespider від ByteDance (12,0%), далі CCBot від Common Crawl (11,9%) і GPTBot від OpenAI (11,5%); боти, які…
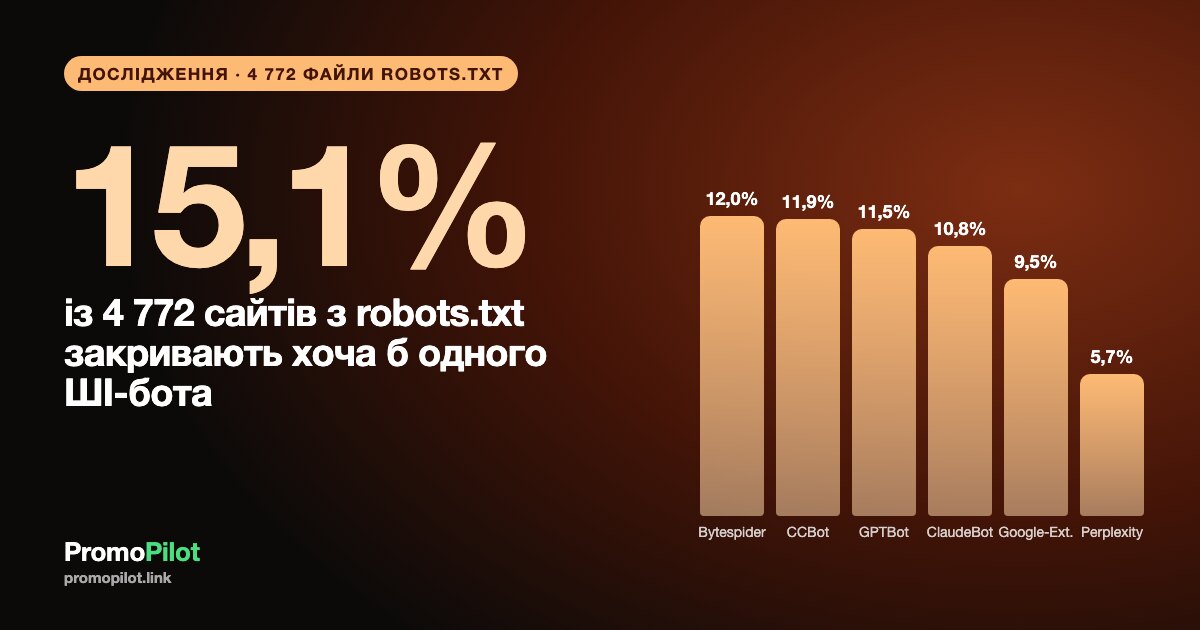
15–16 листопада 2026 року ми прочитали robots.txt у 4 772 сайтів: 15,1% з них (719) правилом Disallow: / закривають весь сайт щонайменше від одного ШІ-краулера. Найчастіше закривають Bytespider від ByteDance (12,0%), далі CCBot від Common Crawl (11,9%) і GPTBot від OpenAI (11,5%); боти, які беруть сторінки для живих відповідей і ШІ-пошуку, закриті помітно рідше (OAI-SearchBot 3,6%). Окремо: справжній файл llms.txt є у 22,5% із 5 071 сайту, а у сайтів, що закривають ШІ-ботів, він трапляється рідше (15,6% проти 25,1%). Далі: рейтинг ботів, розбір того, що це за боти і що дає та чого не дає їх блокування, картина за llms.txt, таблиця рішення для вашого сайту та методологія. Застереження: вибірка не випадкова (сайти з нашого кешу видачі), тож цифри описують саме її, а не весь інтернет.
Дані: обхід PromoPilot, 6 000 сайтів, 15–16 листопада 2026 (перевірка llms.txt 16 листопада); виключено 661 сайт за WAF, 178 недоступних і 90 з іншими помилками, у розрахунку 5 071, robots.txt знайдено у 4 772
Ключові цифри
- 15,1% сайтів (719 із 4 772 з robots.txt) закривають щонайменше одного з 10 відстежуваних ШІ-ботів. У 121 із них (2,5% усіх сайтів) є ще й загальний
Disallow: /для всіх краулерів, тому частка, спрямована саме на ШІ-ботів, це 598 сайтів, 12,5%. - Рейтинг за ботами: Bytespider 12,0%, CCBot 11,9%, GPTBot 11,5%, ClaudeBot 10,8%, Google-Extended 9,5%, anthropic-ai 8,8%, Applebot-Extended 8,2%, PerplexityBot 5,7%, ChatGPT-User 5,3%, OAI-SearchBot 3,6%.
- Блокування здебільшого за принципом «все або нічого»: із 719 сайтів, що закривають, 379 (52,7%) закривають 7 і більше із 10 ботів, 95 (13,2%) закривають усіх 10, а 100 (13,9%) закривають рівно одного.
- Навчання проти живого пошуку відповіді: 15,0% сайтів закривають щонайменше одного навчального бота, 6,6% закривають щонайменше одного пошукового або відповідного бота, а 8,4% закривають лише навчальних. Із 549 сайтів, що закривають GPTBot, 382 (69,6%) залишають OAI-SearchBot відкритим.
- Content-Signal (директива robots.txt для уподобань щодо search, ai-input і ai-train) є на 5,4% сайтів (258); 90 із них використовують її, не закриваючи жодного бота.
- llms.txt: справжній файл на 22,5% із 5 071 сайту (1 139), llms-full.txt на 5,1% (259); 8,6% (435) відповідають 200 з HTML-заглушкою або редиректом, їх ми не рахуємо; 63,5% повертають 404.
- Сайти, що закривають ШІ-ботів, рідше віддають llms.txt: 15,6% (112 із 719) проти 25,1% (1 019 із 4 053, що не закривають), серед сайтів з robots.txt.
- За CMS (метатег generator): без метатега generator щонайменше одного ШІ-бота закривають 17,6% сайтів, WordPress 9,3% (462 сайти), Drupal 19,1% (47), інші CMS і конструктори 5,3% (587).
Рейтинг: скільки сайтів закривають кожного ШІ-бота
Для кожного сайту ми розібрали robots.txt і зафіксували, які з 10 ШІ-юзер-агентів заборонено на весь сайт. База: 4 772 сайти, де знайдено robots.txt (94,1% із 5 071, які вдалося прочитати). Рейтинг нижче.

| # | Бот | Сайтів закривають | Частка від 4 772 |
|---|---|---|---|
| 1 | Bytespider | 571 | 12,0% |
| 2 | CCBot | 569 | 11,9% |
| 3 | GPTBot | 549 | 11,5% |
| 4 | ClaudeBot | 515 | 10,8% |
| 5 | Google-Extended | 452 | 9,5% |
| 6 | anthropic-ai | 421 | 8,8% |
| 7 | Applebot-Extended | 391 | 8,2% |
| 8 | PerplexityBot | 271 | 5,7% |
| 9 | ChatGPT-User | 254 | 5,3% |
| 10 | OAI-SearchBot | 173 | 3,6% |
Видно дві закономірності. Перша: перші сім позицій займають боти, що збирають дані для навчання моделей, або пов’язані з навчанням токени, а три останні пов’язані з пошуком і відповідями. «Бота, який вчиться на моєму контенті» власники блокують значно охочіше, ніж «бота, який може привести відвідувача». Друга: застарілий токен anthropic-ai (8,8%) закривають майже так само часто, як ClaudeBot (10,8%): обох закрили 384 сайти, щонайменше одного з двох 552 (11,6% усіх), і це схоже на те, що багато robots.txt копіюють із готових списків, а не пишуть по кожному боту окремо.
Для більшості сайтів блокування за принципом «все або нічого»
719 сайтів, що закривають, не обирають бота за ботом. Половина з них (379) закриває сім і більше ботів, 95 закривають усіх десятьох, і лише 100 закривають одного.

Одне уточнення щодо самої цифри. Наш парсер вважає бота закритим, коли його правило забороняє весь сайт. У 121 із 719 сайтів є ще й загальний Disallow: / для всіх краулерів, який закриває сайт і від пошукових систем (2,5% усіх сайтів з robots.txt; частина з них це сайти, що створюються). Якщо потрібна частка саме щодо ШІ-ботів, їх слід відняти: 598 сайтів, 12,5%.
Анатомія: що це за боти і що дає та чого не дає їх блокування
«Заблокувати ШІ» це не одне рішення. Десять юзер-агентів виконують три різні роботи: збирають сторінки для навчання моделей, будують пошуковий індекс, який відповідає на запитання з посиланнями, і відкривають сторінку просто зараз, бо людина попросила про це асистента. Наслідки блокування в кожному випадку різні. Описи спираються на публічну документацію вендорів у тому вигляді, в якому ми читали її у листопаді 2026 року; документація краулерів змінюється, тож перед тим як покладатися на деталь, перевірте сторінки за посиланнями.
| Бот | Чий | Завдання | Що дає блокування | Чого не дає |
|---|---|---|---|---|
| GPTBot | OpenAI | Навчальний краулер | Просить OpenAI не використовувати ваші сторінки для навчання майбутніх моделей | Не прибирає вас із пошуку ChatGPT: той працює через OAI-SearchBot |
| OAI-SearchBot | OpenAI | Пошуковий індекс для видачі пошуку ChatGPT | Просить OpenAI не включати ваші сторінки в пошукові функції | Не навчальний краулер: його блокування не зупинить навчання |
| ChatGPT-User | OpenAI | Відкриває сторінку, коли її просить користувач або кастомний GPT | Просить OpenAI не відкривати ваші сторінки на запит користувачів | OpenAI зазначає, що правила robots.txt можуть не діяти для цих візитів за запитом користувача |
| ClaudeBot | Anthropic | Навчальний краулер | Просить Anthropic не збирати ваші сторінки для навчання | Не охоплює Claude-User (запити користувачів) і Claude-SearchBot (пошук): Anthropic перелічує їх окремо |
| anthropic-ai | Anthropic | Старіший токен для навчання | Старий токен. У поточній документації Anthropic перелічені ClaudeBot, Claude-User і Claude-SearchBot; залишити anthropic-ai у списку не шкідливо | Багато сайтів пишуть його за звичкою |
| Google-Extended | Токен robots.txt, а не окремий краулер; керує використанням контенту для навчання й grounding Gemini | Виводить ваш контент із цих сценаріїв Gemini | Не змінює обхід і індексацію в Google Search; Google зазначає, що токен не керує функціями Пошуку, як-от AI Overviews | |
| Applebot-Extended | Apple | Токен; керує тим, чи використовується контент, зібраний Applebot, для навчання моделей Apple | Виводить ваш контент із цього навчання | Сам Applebot продовжує обхід для пошуку Siri і Spotlight |
| PerplexityBot | Perplexity | Індексує сторінки для пошуку Perplexity | Просить Perplexity не показувати ваші сторінки у видачі | Perplexity каже, що його не використовують для навчання базових моделей; візити за запитом користувача йдуть іншим агентом |
| CCBot | Common Crawl | Будує відкритий архів вебу, який багато розробників ШІ використовують для навчання | Не пускає нові сторінки в майбутні набори Common Crawl | Не видаляє те, що раніші обходи вже зберегли |
| Bytespider | ByteDance | Краулер для продуктів і моделей ByteDance | Просить ByteDance не обходити сайт | Деякі власники сайтів повідомляють, що він ігнорує robots.txt; якщо це важливо, блокуйте ще й на рівні сервера або CDN |
Чотири речі, яких robots.txt не вміє
- Це прохання, а не замок. Коректний краулер його читає, некоректний ні. Щоб блокування працювало, використовуйте правила CDN, фаєрволу чи вебсервера (саме цей сильніший інструмент застосовують 661 сайт, що відповіли нашому краулеру сторінкою блокування WAF).
- Воно не діє назад. Воно впливає на майбутні обходи. Контент, який краулер уже зібрав або який лежить у старішому архіві Common Crawl, нікуди не зникає.
- Навчання і відповіді це окремі перемикачі. Закрити навчальних ботів (GPTBot, ClaudeBot, Google-Extended) і закрити тих, від кого залежить, чи зможуть вашу сторінку процитувати у відповіді ШІ (OAI-SearchBot, PerplexityBot), це різні рішення. У наших даних 8,4% сайтів закривають лише навчальних, 6,6% закривають обидві групи, а лише ботів пошуку закривають усього 4 сайти.
- Воно не ховає сторінку від Google Search. Google-Extended окремий від Googlebot. Блокування першого не чіпає звичайний пошуковий обхід, тоді як загальний
Disallow: /або блок Googlebot закривають сайт від пошуку.
Де сайти розходяться: навчання чи пошук відповіді
Візьмемо OpenAI. Із 549 сайтів, що закривають GPTBot, 249 (45,4%) закривають і ChatGPT-User, а 167 (30,4%) і OAI-SearchBot; 382 (69,6%) закривають навчальний краулер, але залишають пошуковий відкритим. Це цілісна політика: відмовитися від навчання й залишитися доступним для пошуку ChatGPT. Пара Google поводиться схоже: 121 сайт закриває GPTBot без Google-Extended, а 24 закривають Google-Extended без GPTBot.
Новіша директива Content-Signal виражає той самий поділ в одному рядку, з окремими значеннями yes або no для search, ai-input і ai-train. Вона є на 5,4% сайтів (258). Із них 168 (65,1%) ще й закривають щонайменше одного ШІ-бота за іменем, а 90 використовують лише сигнал. Ми фіксуємо лише наявність директиви; чи дотримується її конкретний краулер, вирішує сам краулер.
llms.txt: скільки сайтів мають справжній файл
llms.txt це пропозиція 2024 року: файл Markdown за адресою /llms.txt, що перелічує для мовних моделей найкорисніші сторінки сайту з короткими описами; llms-full.txt це довший варіант із вбудованим вмістом. Це не офіційний стандарт, і на момент написання нам не відомо жодного великого ШІ-вендора, який підтвердив би, що використовує ці файли для пошуку чи ранжування, тож розглядайте його як недорогу документацію для машин, а не важіль видимості. Ми все одно його перевірили, бо це друга половина питання «що сказати ШІ».
«Справжнім файлом» ми вважаємо лише адресу, що відповідає 200, не є HTML-сторінкою і не перенаправляє на іншу сторінку. Так відпадає 435 сайтів (8,6%), які відповідають 200 з HTML-сторінкою (soft 404 або заглушка) або редиректом.

| Показник | Сайтів | Частка |
|---|---|---|
| Справжній файл llms.txt | 1 139 | 22,5% від 5 071 |
| Справжній файл llms-full.txt (усі вони мають і llms.txt) | 259 | 5,1% від 5 071 |
| 200 з HTML-заглушкою або редиректом (не рахуємо) | 435 | 8,6% від 5 071 |
| 404 | 3 218 | 63,5% від 5 071 |
| Справжній llms.txt серед сайтів, що закривають ШІ-ботів | 112 із 719 | 15,6% |
| Справжній llms.txt серед сайтів, що не закривають (robots.txt знайдено) | 1 019 із 4 053 | 25,1% |
Як виглядають справжні файли: медіана 5 922 байти, 90-й перцентиль 56 975 байтів; 77,9% починаються із заголовка (H1), як радить формат; 89,0% містять щонайменше одне посилання Markdown (у медіанному файлі їх 24); у 10,3% посилань немає, і це фактично звичайний текст. 11,6% віддаються як text/markdown, решта як text/plain.
Зв’язок із блокуванням лише кореляція: сайти, що закривають ШІ-ботів, рідше публікують файл, написаний для ШІ-систем (15,6% проти 25,1%), що узгоджується з простим прочитанням: ці сайти свідомо не взаємодіють зі ШІ, а інші свідомо взаємодіють. Стверджувати, що одне породжує інше, ми не можемо; частину файлів автоматично створюють плагіни й конструктори (частка серед сайтів на інших CMS і конструкторах 35,3%, на WordPress 25,5%, без метатега generator 20,6%). До того ж наша вибірка зміщена до сайтів, що потрапляють у видачу.
За CMS і за мовою
CMS визначено за метатегом generator; 3 598 із 4 772 сайтів його не публікують, і це найбільша група та група з найчастішим блокуванням. Групи менше 30 сайтів не показано. Примітка: імена хостів у наших даних захешовані, тому розбивка за доменною зоною (TLD) неможлива; як найближчий географічний сигнал ми показуємо мову сторінки, заявлену в HTML.

| CMS (метатег generator) | Сайтів з robots.txt | Закривають будь-якого ШІ-бота | Закривають GPTBot | Файл llms.txt (від усіх сайтів групи) |
|---|---|---|---|---|
| Без метатега generator | 3 598 | 17,6% (632) | 13,4% | 20,6% (793 із 3 856) |
| Інша CMS або конструктор | 587 | 5,3% (31) | 4,6% | 35,3% (218 із 618) |
| WordPress | 462 | 9,3% (43) | 7,1% | 25,5% (120 із 471) |
| Drupal | 47 | 19,1% (9) | 8,5% | 10,6% (5 із 47) |
| MediaWiki | 42 | 4,8% (2) | 2,4% | 2,4% (1 із 42) |
| Joomla | 36 | 5,6% (2) | 2,8% | 5,4% (2 із 37) |
Розбивку за CMS читайте обережно. Сайти без метатега generator часто є індивідуальними розробками, магазинами та більшими комерційними сайтами, а в їхніх власників політика трапляється найчастіше; сайти на готових платформах здебільшого лишають типовий robots.txt платформи. Різниця стосується того, хто веде сайт, не менше, ніж того, яке програмне забезпечення він використовує. Групи Drupal і MediaWiki невеликі (47 і 42 сайти).
| Мова HTML | Сайтів з robots.txt | Закривають будь-якого ШІ-бота | Закривають GPTBot |
|---|---|---|---|
| en | 1 655 | 12,6% (208) | 8,6% |
| ru | 823 | 7,2% (59) | 4,5% |
| uk | 516 | 10,1% (52) | 5,6% |
| мову не вказано | 505 | 34,7% (175) | 32,7% |
| sv | 336 | 13,7% (46) | 11,3% |
| de | 311 | 19,6% (61) | 17,4% |
| pl | 102 | 16,7% (17) | 9,8% |
| he | 89 | 11,2% (10) | 5,6% |
| es | 85 | 22,4% (19) | 20,0% |
| fr | 72 | 13,9% (10) | 11,1% |
| nl | 35 | 14,3% (5) | 2,9% |
Німецькомовні й іспаномовні сайти цієї вибірки закривають частіше, ніж англомовні, російськомовні й україномовні. Група без заявленої мови виділяється на рівні 34,7%, це більш ніж удвічі вище за середнє по вибірці; чому так, ми не аналізували. Сприймайте таблицю за мовами як опис цієї вибірки, а не як національну статистику: вибірка походить із пошукових запитів, які ми відстежуємо.
Як вирішити для свого сайту
Універсально правильного налаштування немає. Рішення залежить від того, чого ви хочете від ШІ-систем: щоб вас знаходили й цитували, щоб контент не потрапляв у навчання, чи і те, і інше водночас. Скористайтеся таблицею як відправною точкою, а потім перевірте результат.
| Ваша ситуація | Розумна позиція в robots.txt | На що звернути увагу |
|---|---|---|
| Ви хочете потрапляти у відповіді ШІ та пошук (послуги, локальний бізнес, B2B, магазин) | Дозвольте OAI-SearchBot, PerplexityBot і ChatGPT-User; навчальних ботів дозвольте або не згадуйте | Блокування пошукових ботів виводить вас із пулу, де вас могли б процитувати; не копіюйте випадково список «закрити все» |
| Ви не проти, щоб вас знаходили, але не хочете, щоб текст ішов у навчання | Закрийте GPTBot, ClaudeBot (за бажання й anthropic-ai), CCBot, Google-Extended, Applebot-Extended; пошукових і користувацьких залиште відкритими | Не діє назад; частина краулерів може ігнорувати; цю політику застосовують 8,4% сайтів у наших даних |
| Платний або закритий для учасників контент, оригінальні дослідження, медіаархів | Закрийте всіх навчальних ботів, щодо ботів пошуку відповіді вирішуйте за кожним окремо й забезпечуйте виконання правилами CDN чи фаєрволу, а не лише robots.txt | Robots.txt не зупинить краулер, який його ігнорує; перевіряйте логи сервера |
| Ви не хочете від ШІ-систем нічого | Закрийте всіх десятьох відстежуваних ботів (так роблять 13,2% сайтів, що закривають) і додайте правила на рівні сервера | Не використовуйте загальний Disallow: / для *: він закриває сайт і від пошукових систем |
| Чіткої політики поки немає | Залиште як є, додайте рядок Sitemap, фіксуйте, які боти заходять на сервер, і перегляньте через квартал | Неперевірений список, скопійований із мережі, найчастіша причина випадкових блокувань |
Короткий чекліст:
- Відкрийте власний
/robots.txtі пошукайте десять імен вище. Наш безкоштовний аналізатор robots.txt розбирає файл і показує, які правила стосуються якого бота. - Сформулюйте політику одним реченням (наприклад, «дозволяємо пошукових і відповідних ботів, відмовляємо навчальним») і складіть файл за нею. Генератор robots.txt створить групи за вас.
- Переконайтеся, що ви не заблокували Googlebot випадково: ШІ-правила мають називати ШІ-юзер-агентів, а не
*. - Якщо публікуєте llms.txt, розглядайте його як документацію: заголовок, короткий опис і перелік ключових сторінок з однорядковими описами, у вигляді простого тексту або Markdown зі статусом 200. Інструмента для цього в нас немає, а сторінка-заглушка зі статусом 200 гірша за 404, бо краулери не відрізнять її від файлу.
- Переглядайте політику, коли вендор змінює документацію: назви юзер-агентів змінюються (anthropic-ai тому приклад).
Методологія та застереження
Дані походять з нашого власного обходу TRI 6 000 сайтів 15–16 листопада 2026 року: корпус сайтів, що з’являються в результатах Google за запитами, які ми відстежуємо, плюс сайти користувачів і контрольна вибірка. Імена хостів в експорті замінені хешами, публікуємо лише агрегати. Ми виключили 661 сайт (11,0%), які відповіли краулеру сторінкою захисту від ботів (WAF; 420 із них Cloudflare), 178 недоступних сайтів (3,0%) і 90 з іншими помилками сервера чи HTTP (1,5%). 655 сайтів із WAF, які ми повторно перевірили через сім днів, знову виявилися заблокованими. У розрахунку 5 071 сайт; robots.txt знайдено у 4 772 (94,1%), і відсотки в розділах про robots використовують ці 4 772. Частки llms.txt використовують усі 5 071.
Сайт «закриває» бота, коли розібраний robots.txt забороняє юзер-агенту бота весь сайт (Disallow: /). Десять юзер-агентів це ті, що в таблиці рейтингу. Часткові блокування (папка) блокуванням не вважаємо. Content-Signal і загальний Disallow: / для всіх краулерів рахуємо окремо. Критерій «справжнього файлу» llms.txt: статус 200, вміст не HTML, без редиректу на іншу сторінку.
Обмеження:
- Вибірка не випадкова. Її складено із сайтів, що з’являються у видачі за нашими запитами, тож вона зміщена до сайтів, активних у SEO. Не переносьте відсотки на весь веб.
- Сайти за WAF виключено, а це, імовірно, більш захищені й більші сайти; їхня політика robots.txt може відрізнятися.
- Robots.txt показує намір власника, а не те, чи дотримується його бот.
- Ми читаємо правила на один момент; сайти змінюють файли, а ШІ-вендори додають і перейменовують краулери. Ми відстежуємо десять юзер-агентів і не охоплюємо інших (наприклад, новіших окремих агентів, які деякі вендори описують для запитів користувачів).
- CMS визначено за метатегом generator, який більшість сайтів не публікує; мову взято з атрибута
langв HTML. Розбивки за доменною зоною (TLD) немає, бо імена хостів захешовані. - Кореляції (блокування й llms.txt, CMS і блокування) не є причинами.
Дві примітки до цифр. У нашій робочій чернетці від 16.11 379 сайтів описано як такі, що закривають «усіх 7 основних ботів»; остаточний підрахунок: 379 сайтів закривають сім і більше із десяти відстежуваних ботів, із них 95 закривають усіх десятьох. Чернетка також порівнювала 15,6% із 23,6% щодо llms.txt, де друге число бралося по всіх сайтах без ШІ-блокувань, включно з тими, що без robots.txt; тут база однакова (сайти з robots.txt), і виходить 25,1%.
FAQ
Чи потрібно закривати ШІ-ботів у robots.txt?
Залежить від мети. Якщо хочете потрапляти у відповіді ШІ, залиште відкритими пошукових ботів (OAI-SearchBot, PerplexityBot). Якщо ви проти використання тексту для навчання, закрийте навчальних (GPTBot, ClaudeBot, Google-Extended, CCBot, Applebot-Extended). У нашій вибірці з 4 772 сайтів з robots.txt щонайменше одного ШІ-бота закривають 15,1%, лише навчальних 8,4%.
Чи зникну я з ChatGPT, якщо закрию GPTBot?
Ні. GPTBot це навчальний краулер OpenAI. Видача пошуку ChatGPT працює через OAI-SearchBot, а запити користувачів через ChatGPT-User. Із 549 сайтів у наших даних, що закрили GPTBot, 69,6% залишили OAI-SearchBot відкритим.
Чи впливає закриття Google-Extended на позиції в Google?
Google описує Google-Extended як окремий токен, що керує використанням контенту для Gemini; він не є частиною Googlebot і не керує обходом та індексацією в Пошуку. Жодного впливу на позиції, ні позитивного, ні негативного, ми не стверджуємо.
Чи дотримуються ШІ-боти robots.txt?
Великі вендори заявляють, що так, із застереженням: OpenAI зазначає, що візити ChatGPT-User за запитом користувача можуть його не дотримуватися. Robots.txt це добровільний стандарт, і частина власників сайтів повідомляє про краулери, які його ігнорують. Щоб блокування працювало, використовуйте правила CDN або сервера.
Чи потрібен файл llms.txt?
Жоден вендор цього не вимагає, і нам не відомо про підтверджене використання великою ШІ-системою. Справжній файл публікують 22,5% із 5 071 перевіреного сайту. Додати його недорого, і він безпечний, якщо актуальний, але не чекайте, що він змінить видимість.
Як перевірити, яких ШІ-ботів закриває мій сайт?
Відкрийте /robots.txt і пошукайте юзер-агентів із цієї статті або вставте файл в наш аналізатор robots.txt. Щоб створити новий файл, скористайтеся генератором robots.txt.
Джерела
- OpenAI, Overview of OpenAI crawlers: platform.openai.com/docs/bots
- Anthropic, довідкова стаття про краулер і robots.txt: support.anthropic.com
- Google Search Central, Google's common crawlers (Google-Extended): developers.google.com
- Apple, About Applebot: support.apple.com/en-us/119829
- Perplexity, Perplexity crawlers: docs.perplexity.ai/guides/bots
- Common Crawl, CCBot: commoncrawl.org/ccbot
- IETF, RFC 9309, Robots Exclusion Protocol: rfc-editor.org/rfc/rfc9309
- Пропозиція llms.txt: llmstxt.org
- Content Signals Policy: contentsignals.org
Як цитувати
PromoPilot (2026). Скільки сайтів закривають ШІ-ботів у robots.txt: 5 071 сайт, листопад 2026. Дані за 15–16 листопада 2026. CC BY 4.0: https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-robots-5071-sites-2026-11.csv . Стаття: https://promopilot.link/uk/blog/skilky-saytiv-zakryvayut-shi-botiv-u-robots-txt-5071-sayt-2026
Завантажити дані
Агреговані таблиці (CSV, ліцензія CC BY 4.0): https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-robots-5071-sites-2026-11.csv, а також таблиці https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-blocked-count-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-bot-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-cms-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/ai-bots-by-html-lang-2026-11.csv, https://promopilot.link/uploads/blog/research/ai-bots-robots-1911/llms-txt-by-cms-2026-11.csv. Тут лише агрегати, без проєктів, доменів і даних клієнтів.