
Генератор robots.txt
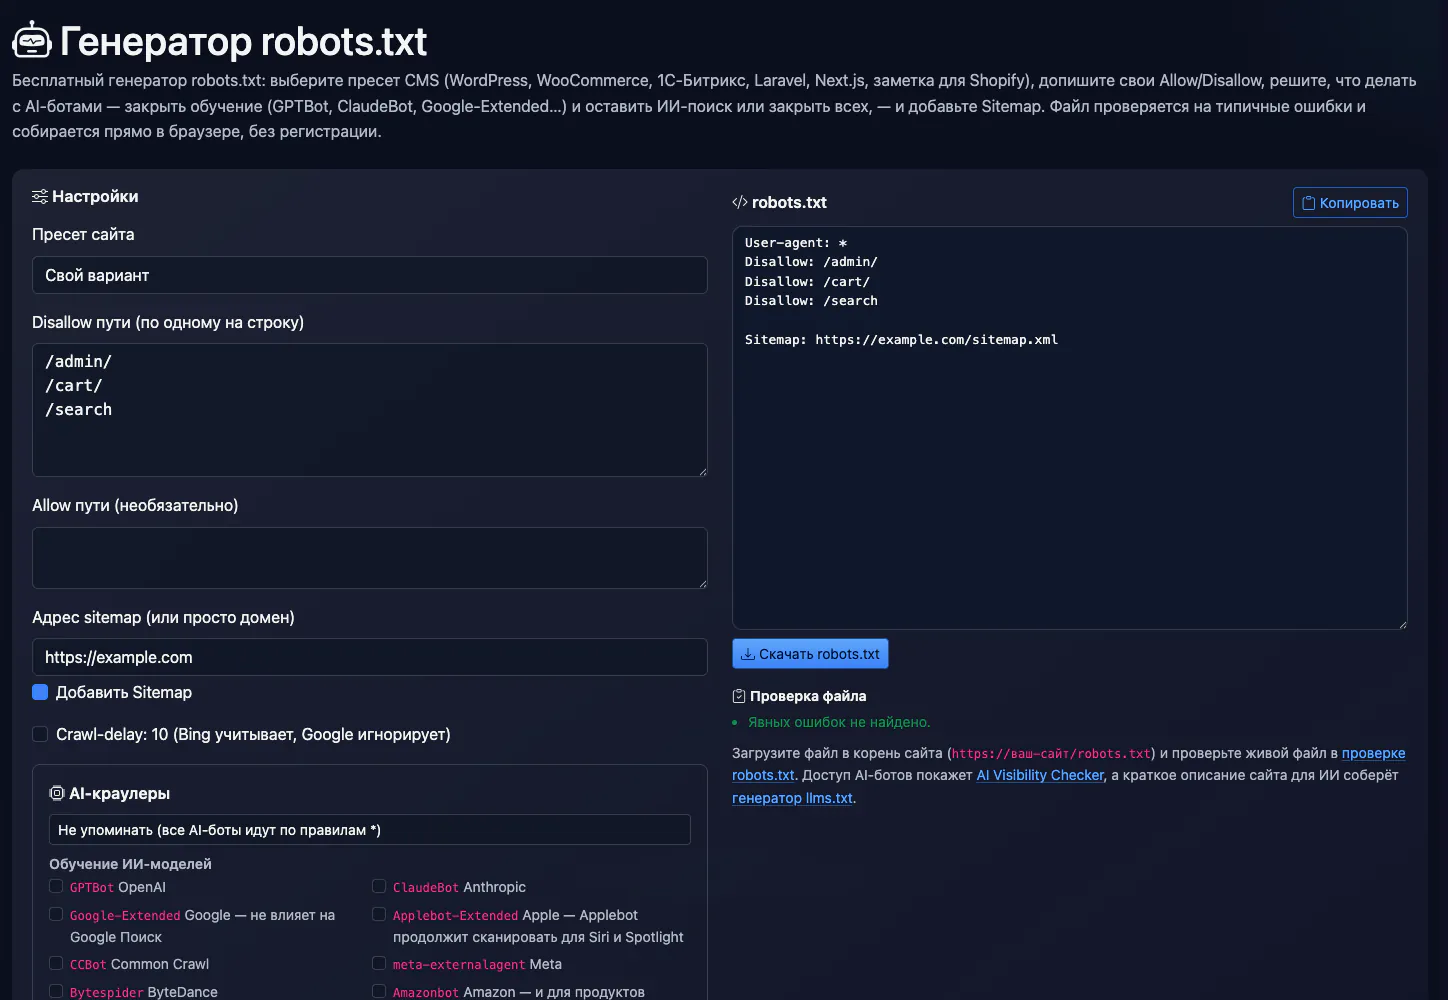
Бесплатный генератор robots.txt: выберите пресет CMS (WordPress, WooCommerce, 1С-Битрикс, Laravel, Next.js, заметка для Shopify), допишите свои Allow/Disallow, решите, что делать с AI-ботами — закрыть обучение (GPTBot, ClaudeBot, Google-Extended…) и оставить ИИ-поиск или закрыть всех, — и добавьте Sitemap. Файл проверяется на типичные ошибки и собирается прямо в браузере, без регистрации.
Настройки
Отмеченные боты получат «Disallow: /». robots.txt — просьба, а не замок: добросовестные боты её соблюдают, остальных останавливает только сервер или CDN (например, блокировка AI-ботов в Cloudflare).
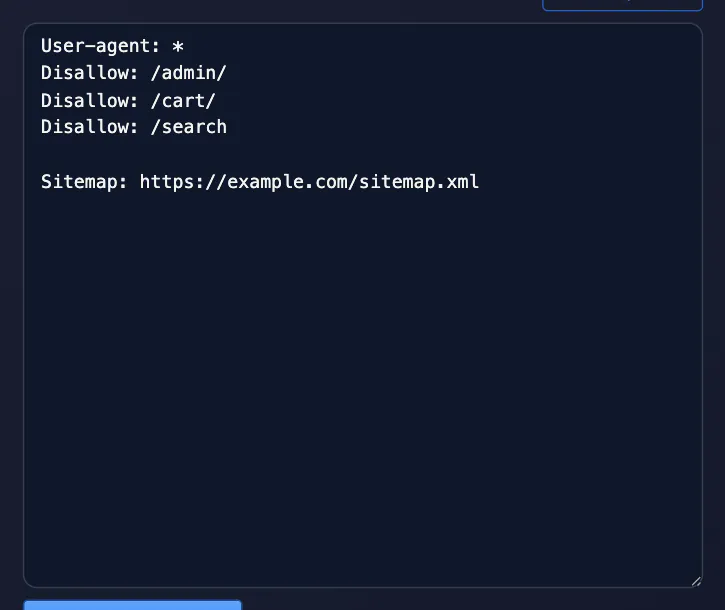
robots.txt
Загрузите файл в корень сайта (https://ваш-сайт/robots.txt) и проверьте живой файл в проверке robots.txt. Доступ AI-ботов покажет AI Visibility Checker, а краткое описание сайта для ИИ соберёт генератор llms.txt.
Коротко об инструменте
robots.txt — текстовый файл в корне сайта, в котором вы просите роботов не заходить в некоторые разделы. Выберите пресет (WordPress, WooCommerce, Битрикс, Next.js и др.), добавьте свои пути, Sitemap и при желании закройте AI-ботов, затем скопируйте результат. Это просьба, а не защита: добросовестные боты её соблюдают, остальные нет, а закрытая страница всё равно может попасть в индекс.
- Цена
- Бесплатно
- Регистрация
- Не нужна
- Где идёт обработка
- В вашем браузере — данные не отправляются на сервер
- Что принимает
- Пресет сайта, пути Disallow и Allow (по одному на строку), адрес Sitemap, флажки Crawl-delay и список AI-ботов
- Лимиты
- Без регистрации и без лимитов; только генерация и проверка текста, файл на сайт нужно выложить самостоятельно
- Результат
- Готовый текст robots.txt с кнопкой «Копировать» или «Скачать» и список предупреждений (конфликт Allow и Disallow, закрытие всего сайта, Crawl-delay)
- Обновлено
Видеообзор 0:56 на английском, субтитры: русский

Генератор robots.txt бесплатно: пресеты CMS + блокировка ИИ-ботов (GPTBot, ClaudeBot)
Бесплатно создайте robots.txt: пресеты CMS (WordPress, WooCommerce, Shopify…), собственные правила, строка Sitemap и готовые пресеты для ИИ-краулеров.
Содержание видео
Текст видео
Write a robots.txt file, and decide what to do about AI crawlers. Here's a free generator that does both. Pick a site preset: WordPress, WooCommerce, Shopify and others. I'll choose WordPress, and the rules for its admin area and search pages appear on the right. Then the AI crawlers section. The preset, Block AI training, allow AI search, disallows the training bots like GPTBot and ClaudeBot, but leaves the search bots alone. Add a sitemap line, and download the file. Robots.txt is a request, not access control. It blocks crawling, not indexing. Blocking Google-Extended doesn't hurt your Google rankings. Free, no sign-up. The link is in the description. Subscribe for more free tools.
Как это выглядит
Генератор robots.txt онлайн
Генератор robots.txt собирает файл правил для поисковых и AI-ботов: пресеты для WordPress, WooCommerce, 1С-Битрикс, Laravel и Next.js, заметка для Shopify, свои пути Allow/Disallow, строка Sitemap и отдельный блок для AI-краулеров. Ботов обучения (GPTBot, ClaudeBot, Google-Extended и др.) можно закрыть, не трогая ботов ИИ-поиска, которые приводят ссылки на ваш сайт. Результат сразу проверяется на типичные ошибки.
Как пользоваться
- Выберите пресет своей CMS или «Свой вариант» и поправьте пути Allow и Disallow
- Решите, что делать с AI-ботами: не упоминать, закрыть обучение или закрыть всех
- Укажите адрес sitemap и проверьте предупреждения под файлом
- Скачайте robots.txt, загрузите в корень сайта и проверьте живой файл
FAQ
Для кого и сценарии
- Сайт на WordPress или Битрикс. Выберите пресет с типичными служебными путями и добавьте адрес Sitemap.
- Закрыть поиск, фильтры и корзину. Впишите свои пути с шаблонами
*и$, например/*?sort=. - Решение по ИИ-ботам. Закройте только обучение моделей или и ИИ-поиск, решив, нужна ли вам видимость в ответах ИИ.
Честные ограничения
- robots.txt — просьба, а не замок. Недобросовестные боты его игнорируют; OpenAI и Perplexity сами пишут, что для запросов по просьбе пользователя файл может не применяться.
- Закрытая страница может остаться в индексе. Чтобы убрать её из выдачи, нужен noindex, а не Disallow.
- Crawl-delay Google игнорирует. Его учитывает Bing; Google управляет частотой иначе.
- Shopify. Платформа генерирует robots.txt сама, поэтому правила меняют через шаблон robots.txt.liquid, а не загрузкой файла.
- Файл нужно выложить в корень хоста. Для каждого поддомена и протокола нужен свой файл; генератор не публикует и не проверяет сайт.
Дальше по теме: проверка robots.txt, генератор sitemap, видимость в ИИ, llms.txt.
PromoPilot и аналоги: сравнение
Сравниваем только то, что подтверждено на официальных страницах сервисов. Если данные подтвердить не удалось, в ячейке стоит «—».
| Параметр | PromoPilot | Google Search Central: спецификация robots.txt |
|---|---|---|
| Пресеты CMS | ✓ WordPress, WooCommerce, Битрикс, Laravel, Next.js | ✗ |
| Список AI-ботов | ✓ 14 ботов | ✗ |
| Проверка конфликтов правил | ✓ | Правило: побеждает самое конкретное, при конфликте — менее строгое |
| Работа в браузере | ✓ | — |
Таблицу можно прокрутить вбок
Где мы слабее: мы не проверяем опубликованный файл и конкретные URL, нет пресета для Joomla, Drupal и других CMS, а список AI-ботов нужно периодически сверять с их официальными страницами.
Когда выбрать PromoPilot: Когда нужно быстро собрать корректный robots.txt по пресету CMS и проверить его на типичные ошибки. Для проверки уже опубликованного файла и тестирования URL используйте проверку robots.txt или Search Console.
Проверено: . «—» — не подтверждено на официальной странице; условия и цены сервисов меняются, уточняйте на их сайтах.
Как устроен robots.txt
robots.txt — текстовый файл в корне сайта (https://example.com/robots.txt). Он состоит из групп: строка User-agent называет бота, под ней идут правила Allow и Disallow с путями. Главное, что нужно помнить при составлении файла:
- Бот выбирает одну группу — самую точную для своего имени. Если для GPTBot есть своя группа, правила для
*он уже не читает. Поэтому генератор не пишет отдельную группу сAllow: /для «разрешённых» AI-ботов: иначе им открылись бы и/wp-admin/, и всё, что вы закрыли для остальных. - Побеждает самое длинное совпадение.
Allow: /wp-admin/admin-ajax.phpсильнее, чемDisallow: /wp-admin/. При равной длине Google выбирает Allow. - Работают
*и$.Disallow: /*?sort=закрывает любые адреса с параметром сортировки,Disallow: /*.pdf$— все PDF. - Строка
Sitemapне относится к группам и пишется полным адресом. - Google не поддерживает
Crawl-delay; Bing его учитывает. Лимит размера файла для Google — 500 КиБ.
AI-краулеры: кого закрывать и чем это грозит
AI-боты делятся на три группы, и решение по каждой — разное.
| Группа | Боты | Если закрыть |
|---|---|---|
| Обучение моделей | GPTBot (OpenAI), ClaudeBot (Anthropic), CCBot (Common Crawl), meta-externalagent (Meta), Bytespider (ByteDance), Amazonbot (Amazon), а также токены Google-Extended и Applebot-Extended | Контент не пойдёт в будущие наборы данных для обучения. На Google Поиск и Bing это не влияет. |
| ИИ-поиск | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Сайт перестанет появляться со ссылкой в ответах ChatGPT Search, Claude и Perplexity — это уже потеря трафика. |
| Запросы пользователей | ChatGPT-User, Claude-User, Perplexity-User | Ассистент не сможет открыть страницу, когда пользователь сам дал ссылку или попросил найти ответ. OpenAI и Perplexity предупреждают, что эти запросы могут не подчиняться robots.txt. |
Особые случаи. Google-Extended — не отдельный бот, а токен: сканирует сайт обычный Googlebot, а запрет означает «не использовать контент для обучения и ответов Gemini». По документации Google, на попадание в Поиск и ранжирование он не влияет. Applebot-Extended работает так же: запрет убирает контент из обучения моделей Apple, но Applebot продолжит сканировать сайт для Siri, Spotlight и Safari. Amazonbot Amazon описывает как бота для улучшения своих сервисов, данные которого могут использоваться для обучения моделей, — поэтому он в группе обучения.
Самый частый выбор — пресет «Закрыть обучение ИИ, оставить ИИ-поиск»: контент не уходит в обучение, а ссылки из ИИ-ответов продолжают приводить посетителей. Получится такой блок:
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: meta-externalagent
User-agent: Bytespider
User-agent: Amazonbot
Disallow: /
После публикации проверьте, как видят сайт разные AI-боты, в AI Visibility Checker, а если хотите, чтобы ИИ лучше понимал сайт, добавьте файл llms.txt.
robots.txt — просьба, а не замок
Файл соблюдают добросовестные боты; ничто технически не мешает остальным его игнорировать. Если боты нужно остановить по-настоящему, это делается на сервере или в CDN. У Cloudflare, например, есть управляемый robots.txt с правилами для AI-краулеров (доступен на всех тарифах) и отдельная блокировка ботов на уровне сети. И не используйте robots.txt, чтобы спрятать секретные адреса: файл публичный, и строка Disallow: /secret-admin/ только подскажет, где искать.
Пресеты CMS: что в них и почему
- WordPress: закрыты
/wp-admin/(кромеadmin-ajax.php), внутренний поиск/?s=и/search/, ссылки?replytocom=./wp-includes/и/wp-content/plugins/не закрываем: там CSS и JS, без которых Google не отрисует страницу. Файл в корне заменяет виртуальный robots.txt WordPress; в Yoast SEO его можно править в «Инструменты → Редактор файлов». - WooCommerce: к правилам WordPress добавлены корзина, оформление заказа, личный кабинет и ссылки
?add-to-cart=. - 1С-Битрикс: закрыта служебная папка
/bitrix/, но открыты/bitrix/templates/,/bitrix/js/,/bitrix/cache/,/bitrix/components/,/bitrix/panel/и/upload/, иначе Google не увидит оформление и картинки. - Shopify: файл генерирует сама платформа, загрузить свой нельзя. Правила меняют в шаблоне
robots.txt.liquid(Интернет-магазин → Темы → Изменить код → Добавить шаблон → robots); генератор подготовит дополнительные строки. - Laravel: веб-корень —
/public, поэтому/vendorили.envснаружи недоступны и в robots.txt их не перечисляем. Закрыты страницы входа, регистрации и сброса пароля. - Next.js: закрыт только
/api/. Папку/_next/не трогайте — в ней JS и CSS страниц.
Типичные ошибки, которые ловит проверка
- Путь без начального
/(Disallow: admin) — такое правило не сработает. - Закрытые CSS и JS или папки с ними — Google не сможет отрисовать страницу и оценить её как пользователь.
Disallow: /для всех ботов — так закрывают тестовые копии; на рабочем сайте это обнуляет поисковый трафик.- Дубли и одинаковый путь в Allow и Disallow, пробелы и кириллица в путях без кодирования.
- Sitemap относительным адресом или без строки Sitemap вообще. Карту сайта соберёт генератор sitemap.
Запомните: robots.txt запрещает сканирование, а не индексацию. Чтобы убрать страницу из поиска, её нужно оставить открытой и поставить noindex. Готовый файл на сайте проверяйте проверкой robots.txt — она покажет, как правила применяются к конкретному адресу.
Улучшите позиции в поиске
SEO-проблемы могут стоить вам трафика. Каскадный линкбилдинг улучшит видимость сайта в поиске.