Анализ текста по закону Ципфа
Вставьте текст — инструмент построит график «ранг — частота» в логарифмическом масштабе, посчитает наклон, R² и индекс соответствия закону Ципфа и покажет слова, которые встречаются заметно чаще ожидаемого.
Как считаются показатели
- Слова: последовательности букв кириллицы и латиницы (с дефисом и апострофом внутри). Числа и знаки отбрасываются, регистр не учитывается, «ё» приравнивается к «е».
- Наклон и R²: линейная регрессия по точкам log(ранг) — log(частота). Берутся слова, встретившиеся хотя бы дважды (если таких меньше 10 — первые 50 слов): хвост из слов-одиночек образует горизонтальную «ступеньку» и искажает наклон.
- Индекс 0–100 = 60% × близость наклона к −1 (1 при наклоне −1, 0 при отклонении на 0,8 и больше) + 40% × точность прямой (1 при R² = 1, 0 при R² ≤ 0,7). 80+ — высокое соответствие, 60–79 — умеренное, ниже 60 — низкое.
- Колонка «По Ципфу» — классическая формула f₁ / ранг, где f₁ — частота самого частого слова; «Отклонение» — разница с ней. Пометка «чаще нормы» ставится иначе — относительно линии регрессии вашего текста, чтобы пологий или крутой наклон сам по себе не делал «выбросами» все слова: слово не из списка стоп-слов, встречается не меньше 3 раз и в 1,5 раза чаще, чем предсказывает линия. Слово на первом месте отмечается и тогда, когда стоп-слова не исключены, а оно обогнало их все: в живом тексте первые места занимают предлоги, союзы и артикли.
Коротко об инструменте
Закон Ципфа: в естественном тексте частота слова примерно обратно пропорциональна его рангу, а на графике с логарифмическими осями это почти прямая с наклоном около −1. Вставьте текст, и инструмент построит график, посчитает наклон и R² и даст индекс соответствия. Это статистика, а не детектор ИИ: короткий текст, список или смесь языков дадут отклонения.
- Цена
- Бесплатно
- Регистрация
- Не нужна
- Где идёт обработка
- В вашем браузере — данные не отправляются на сервер
- Что принимает
- Текст от 50 слов до 50 000 символов
- Лимиты
- Без регистрации и без лимитов запросов; не менее 50 слов и не более 50 000 символов; на текстах короче 300 слов оценки неустойчивы
- Результат
- Наклон и R² логарифмической прямой, индекс соответствия закону Ципфа 0–100, таблица топ-30 слов с частотами и пометкой стоп-слов, график ранг–частота с идеальной прямой и список слов, встречающихся чаще нормы
- Обновлено
Как это выглядит
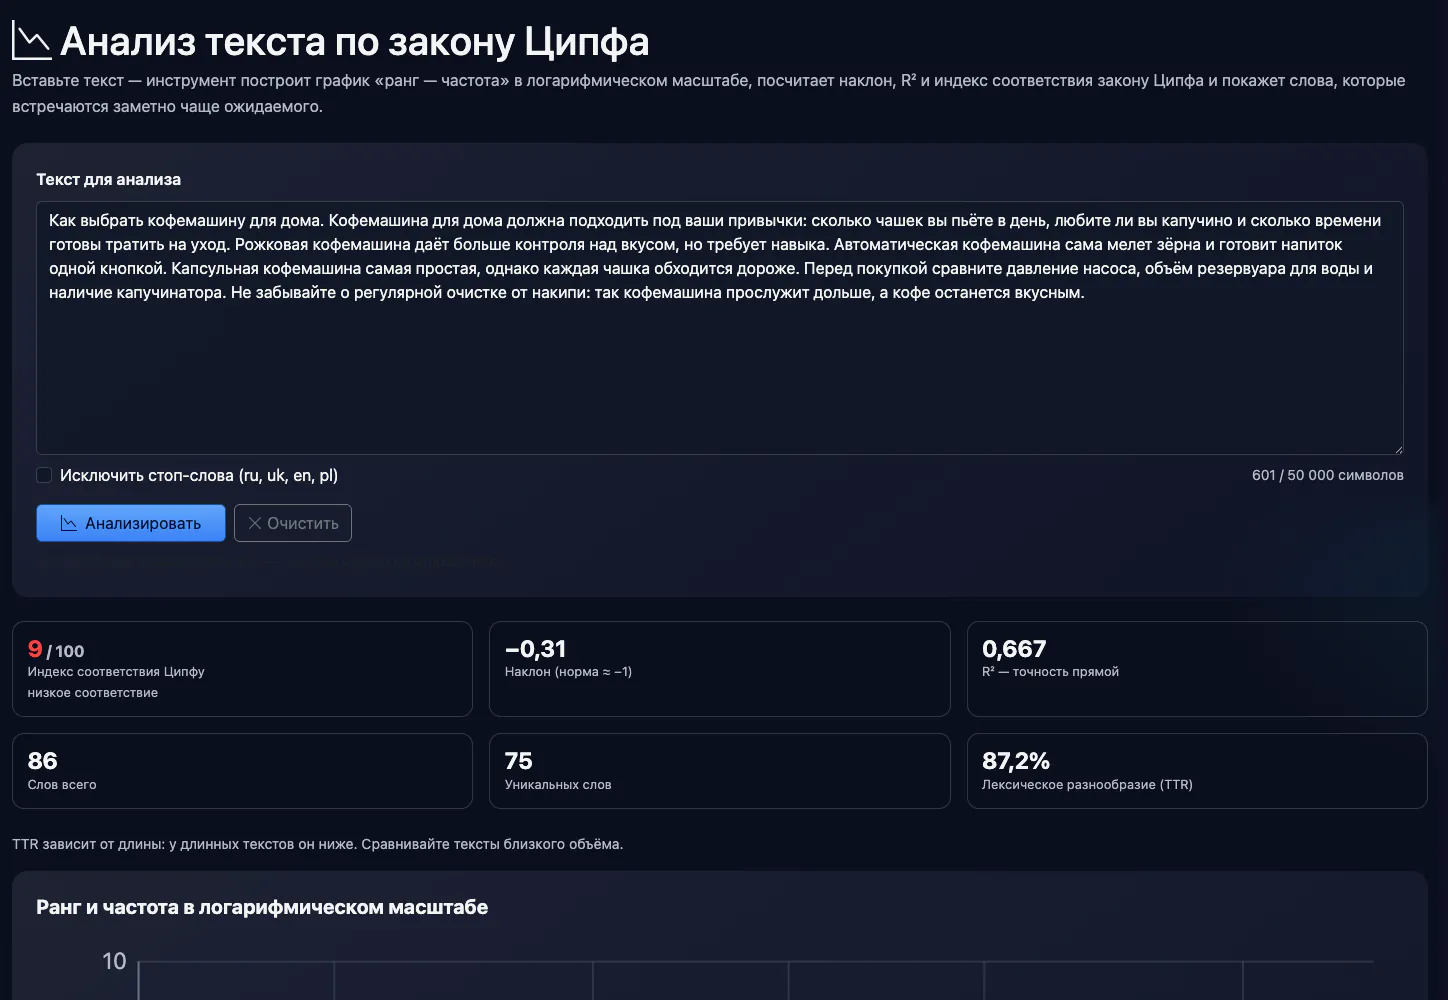
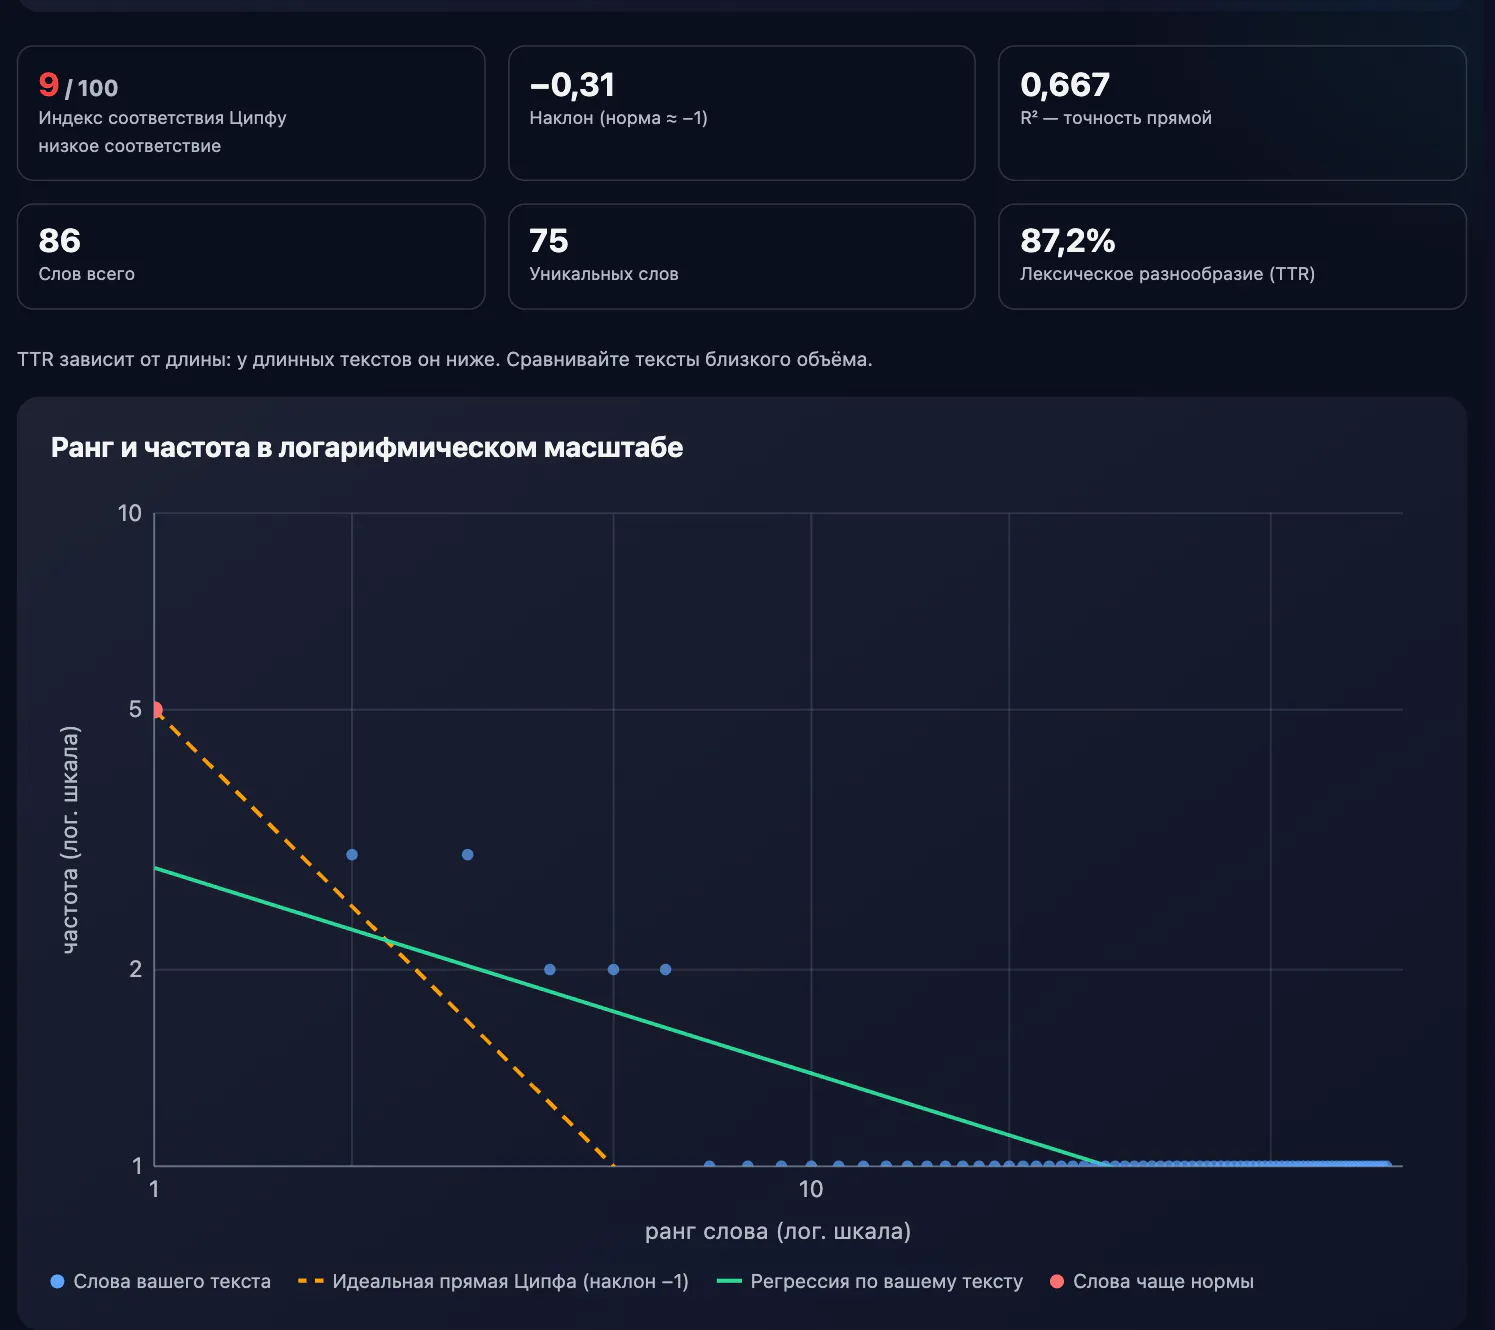
Анализ текста по закону Ципфа онлайн
Проверка текста по закону Ципфа: инструмент считает частоты слов, строит график «ранг — частота» в логарифмическом масштабе рядом с идеальной прямой Ципфа, вычисляет наклон и R² линейной регрессии и сводит их в индекс соответствия 0–100. Слова, которые встречаются заметно чаще, чем предсказывает распределение текста, подсвечиваются — так видно возможный переспам. Расчёт идёт в браузере, регистрация не нужна.
Как пользоваться
- Вставьте текст — от 300 слов, лучше 1000 и больше (до 50 000 символов)
- При необходимости включите исключение стоп-слов и нажмите «Анализировать»
- Посмотрите наклон, R², график и подсвеченные слова в таблице
FAQ
Для кого и сценарии
- Копирайтер и редактор. Найдите слова, которые встречаются заметно чаще нормы, и разбавьте повторы синонимами.
- Студенты и лингвисты. Постройте график ранг–частота для своего корпуса и посчитайте наклон.
- Сравнение вариантов текста. Посмотрите, как меняется индекс после правок или перевода.
Честные ограничения
- Это не детектор ИИ. Соответствие закону Ципфа не доказывает ни человеческого, ни машинного авторства.
- Короткие тексты ненадёжны. Короче 300 слов пара повторов заметно меняет наклон; нужен текст от 50 слов, лучше от нескольких тысяч.
- Списки и смеси языков дают шум. Склеенные фрагменты, перечни и таблицы плохо ложатся на прямую.
- Токенизация простая. Слова режутся по пробелам и знакам, без лемматизации: формы одного слова считаются разными.
- До 50 000 символов. Длинный текст обрезается.
Дальше по теме: плотность ключей, счётчик слов, читаемость, детектор ИИ.
PromoPilot и аналоги: сравнение
Сравниваем только то, что подтверждено на официальных страницах сервисов. Если данные подтвердить не удалось, в ячейке стоит «—».
| Параметр | PromoPilot | Wikipedia: закон Ципфа (справка) |
|---|---|---|
| График ранг–частота с расчётом наклона и R² | ✓ | Описывает, как график в log-log осях показывает соответствие закону; инструмента нет |
| Индекс соответствия 0–100 | ✓ | ✗ |
| Слова, встречающиеся чаще нормы | ✓ | ✗ |
| Без отправки текста на сервер | ✓ | — |
Таблицу можно прокрутить вбок
Где мы слабее: простая токенизация без лемматизации, до 50 000 символов, нет загрузки файлов и сравнения нескольких текстов, а индекс — наша шкала, а не стандартная метрика.
Когда выбрать PromoPilot: Когда нужно за секунды посмотреть частотное распределение слов своего текста, найти слова-перекосы и оценить, насколько текст похож на естественный. Для проверки ИИ-авторства или качества SEO-текста один индекс не годится.
Проверено: . «—» — не подтверждено на официальной странице; условия и цены сервисов меняются, уточняйте на их сайтах.
Анализ текста по закону Ципфа: что именно проверяется
Закон Ципфа описывает, как распределяются частоты слов в естественном тексте. Если отсортировать слова по частоте и пронумеровать (ранг 1 — самое частое слово), частота окажется примерно обратно пропорциональна рангу. Формула закона Ципфа:
f(r) ≈ C / r^s, где s ≈ 1
log f = log C − s · log r
Вторая строка — та же формула после логарифмирования: в координатах log(ранг) — log(частота) получается прямая, а её наклон равен −s. Поэтому проверка по Ципфу сводится к простому вопросу: насколько точки вашего текста похожи на прямую и насколько её наклон близок к −1. Подробнее об истории закона — в статье «Закон Ципфа» в базе знаний.
Важная оговорка: идеальная прямая — модель, а не норматив. У реальных текстов «голова» распределения (первые 5–10 слов) обычно чуть положе прямой, а хвост превращается в ступеньки. Это нормально и описано ещё в уточнённой формуле Мандельброта.
Как читать график «ранг — частота»
На графике три слоя: синие точки — слова вашего текста, оранжевая пунктирная линия — идеальная прямая Ципфа с наклоном −1, проведённая через самое частое слово, зелёная линия — регрессия, построенная по вашему тексту. Смотрите на график по зонам:
- Голова (ранги 1–10). При включённых стоп-словах здесь должны стоять предлоги, союзы, местоимения, в английском — артикли. Если среди них оказалось существительное из ключевой фразы, это первый сигнал переоптимизации.
- Середина (ранги 10–200). Тематическая лексика. Точки должны идти плотной полосой вдоль зелёной линии. Отдельная точка заметно выше полосы — слово, которое повторяется чаще, чем «положено» по распределению текста; такие слова отмечены красным.
- Хвост. Горизонтальные «полки» из слов, встретившихся 2, 3 раза, и длинная полка слов-одиночек. Полки — следствие того, что частота целочисленная, поэтому одиночки в регрессию не берутся.
| Что видно на графике | Что это обычно значит |
|---|---|
| Точки плотно идут вдоль прямой, наклон около −1 | Типичное распределение для связного текста достаточной длины |
| Несколько точек в голове или середине заметно выше полосы | Повторы конкретных слов: ключевая фраза, название бренда, шаблонная вставка |
| Голова почти горизонтальная | Короткий текст, перечень, таблица или исключённые стоп-слова |
| Крутой обрыв после первых слов | Бедный словарь, текст крутится вокруг пары слов |
| Большой разброс, низкий R² | Склеенные фрагменты на разные темы, много списков, кода или чисел |
Какой наклон считать нормальным
Наклон −1 — ориентир для больших массивов текста. На коротких текстах он почти всегда положе: за 1–3 тысячи слов большая часть словаря успевает встретиться один-два раза. Ещё сильнее влияет морфология. Инструмент не приводит слова к начальной форме, поэтому «сайт», «сайта» и «сайту» считаются разными словами. В русском, украинском и польском частоты дробятся по падежам, и наклон −0,6…−0,8 для статьи в несколько тысяч слов — обычная картина, а не дефект. Английский текст той же длины обычно ближе к −1.
Поэтому индекс соответствия полезнее как способ сравнения, а не как оценка «хорошо/плохо». Сравнивайте тексты одного языка и близкого объёма: свою статью до и после правки, свою и конкурентов из топа.
Пример: как переспам меняет распределение
Условный пример. Статья на 2 000 слов о продвижении сайтов, в каждый третий-четвёртый абзац вставлена фраза «продвижение сайта в Москве недорого». В исходной версии первые места занимают «и», «в», «не», «на», а тематические слова начинаются с 7–10-го ранга. После вставок «сайта» и «продвижение» поднимаются на 1–3-е места вперёд предлогов, а «недорого» и «Москве» встают в один ряд со служебными словами. На графике это несколько красных точек над полосой в голове распределения, в таблице — пометки «чаще нормы» и отклонение от f₁/ранг в сотни процентов.
Если включить «Исключить стоп-слова», картина станет нагляднее: из распределения пропадут служебные слова, и четыре слова ключевой фразы окажутся сильно выше линии регрессии. Точный процент каждого повтора удобно посмотреть в анализе плотности ключевых слов — он считает и фразы из 2–3 слов.
Закон Ципфа в SEO-копирайтинге
- Проверка перед публикацией. Прогоните готовый текст и посмотрите на голову распределения и красные точки. Слово из ключевой фразы на первом месте среди предлогов — повод заменить часть повторов синонимами и местоимениями.
- Сравнение с топом. Возьмите 3–5 страниц из выдачи по вашему запросу и сравните наклон и подсвеченные слова. Если у конкурентов ключ стоит в середине распределения, а у вас в голове, вы переборщили.
- Контроль после переписывания. После рерайта или работы над формулировками проверьте, не стал ли словарь беднее: крутой обрыв и падение TTR при той же длине говорят о повторяющихся оборотах.
- Связка с другими проверками. Ципф показывает форму распределения, плотность — конкретные проценты, а AI-детектор — совокупность из многих метрик. Выводы лучше делать по всем трём.
Ограничения метода
- Длина. До 300 слов оценки неустойчивы: два-три повтора меняют наклон на десятые.
- Структура. Списки товаров, таблицы характеристик, код и FAQ-блоки нарушают распределение сами по себе. Для честной оценки анализируйте основной текст.
- Смешение языков. Латинские термины в русском тексте и наоборот считаются наравне со всеми словами и могут сдвигать картину.
- Не фактор ранжирования. Поисковые системы не публикуют «норму Ципфа». Закон — измерительный инструмент, подгонять текст под прямую бессмысленно.
- Не доказательство ИИ. Сгенерированные тексты тоже подчиняются закону Ципфа, а человеческие нарушают его из-за жанра. Отклонение — повод перечитать текст, а не вердикт.
RankBotAI — ИИ-оптимизация SEO для WordPress
AI-плагин RankBotAI автоматически находит и исправляет SEO-проблемы в товарах и записях WordPress — без ручного редактирования.